Потоки и LLM: ограничить очередь до создания задач
Статус: предложение, не реализовано. Инвазивность: Средняя. Основа: webrtc-komaroff@772de4a, 16.09.2026.
WhisperStreamNode.handle_frame создаёт task на каждый кадр. Semaphore ограничивает число одновременно выполняемых publish, но все остальные tasks уже существуют и удерживают payload. Такая же форма есть в LLM BaseService: входящие сообщения превращаются в tasks до semaphore.
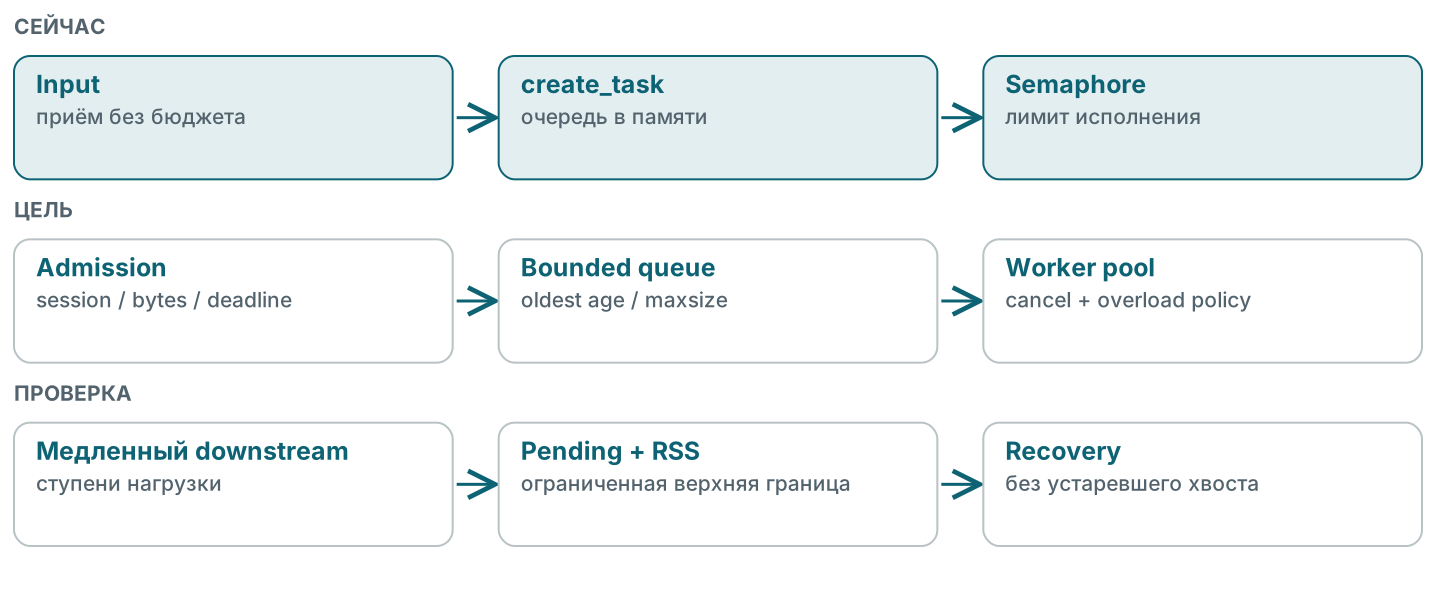
Ограничивать нужно входной буфер, а не только исполнителей. Иначе при медленном backend память и задержка продолжают расти, хотя число активных вызовов выглядит нормальным.
Предлагаемая правка
Для аудио ввести один publisher-worker на stream и bounded queue с учётом байтов и возраста. Кадр поступает в очередь без отдельной task. При заполнении нужна явная политика: краткое ожидание в пределах latency budget, затем сигнал перегрузки и корректное завершение потока либо согласованный gap protocol. Молчаливое выпадение PCM нельзя считать безопасным: оно меняет временную шкалу и распознавание.
В LLM adapter использовать ограниченную очередь запросов и фиксированное число workers. До дорогостоящего inference проверять дедлайн. В контракты добавить deadline/cancellation совместимым способом: Pydantic сейчас запрещает лишние поля. Не полагаться на timeout ожидающего NATS request как на отмену работы responder.
Время очереди измерять отдельно. Текущий duration_ms LLM начинает отсчёт уже внутри semaphore и скрывает ожидание.
Масштабирование звука требует ещё одного решения
Whisper хранит буфер в RAM по stream subject и получает wildcard без queue. Обычные реплики дублируют обработку. Случайная queue group для каждого PCM frame разрушит целостность потока. Для живого аудио закрепить stream за worker: ingress directory, стабильный shard-key или отдельный session owner. Core peer connection также остаётся у создавшего его процесса до завершения.
Эта часть пересекает оба репозитория и не должна попадать в MR только для WebRTC producer без совместимого consumer.
Проверяемые пределы
При 16 кГц mono s16 один поток создаёт 50 кадров/с и 32 000 байт PCM/с. Например, предлагаемый, ещё не принятый бюджет 0.5 с — 25 кадров и 16 000 байт PCM на stream без overhead. Выбирать его нужно по допустимой задержке и тестам качества.
Приёмка: размер очереди никогда не превосходит заданного предела; количество tasks перестаёт зависеть от числа входных frames; очередь не содержит просроченных запросов после drain. Нагрузочный прогон: 1/10/50 потоков, искусственная пауза NATS/backend, reconnect и отсутствие end. Снять RSS, pending bytes, p95 queue wait, возраст старейшего кадра и число отказов admission.
Для deadline проверить согласованность source defaults и DRS: frontend default 70 с, DRS frontend 300 с; Agent default 60 с, DRS 270 с; Core DRS request timeout 600 с. Это разные конфигурации, а не доказанный production timeout-инцидент.
Цена и откат
Появится явный отказ при перегрузке там, где раньше росло ожидание. Это нужно показать в UI. Вводить limits постепенно с метрикой would-reject, затем включать enforcement. При rollback протокол frame/end должен остаться совместимым; новые поля требуют versioned rollout.
Основания
Audio tasks, LLM BaseService, settings и DRS. Python asyncio.Queue документирует maxsize и блокирующий put; Queue.shutdown появился только в Python 3.13, тогда как образы проекта — 3.11. Для текущего runtime нужен совместимый drain/cancel. Context7 NATS queue groups подтверждает случайное распределение сообщений внутри группы: оно не обеспечивает affinity сессии.
Все предложения · Фактическая архитектура