Whisper Diarization Stack
Этот документ описывает рабочий stack для /whisper-diarize, фактический обмен данными между сервисами и проблемы, которые проявились в production при запуске pyannote diarization.
Что сейчас считается рабочей схемой
- browser открывает
/whisper-diarize src/webui/server.pyпринимает upload и публикуетinference.whisper.file.jobsrc/stt_whisper_to_nats.pyподнимает file worker, нормализует медиа вnormalized.wav, режет его на chunk-ы и отправляет chunk-ы вLINTO_HTTP_URL- тот же worker параллельно отправляет
normalized.wavвDIARIZATION_HTTP_URL src/pyannote_diarization_server.pyвыполняет speaker diarization и публикует real progress по NATS- browser получает:
- file job progress/result из
inference.whisper.file.event.<job_id> - diarization progress/result из
inference.whisper.file.diar_text.session.<session_id>
Текущий production deploy:
- ASR (
linto_stt_whisper_http) работает на GPU - diarization (
llm-models_pyannote_diarization) работает на CPU - progress speaker separation приходит двумя слоями:
- coarse stage events из
stt_whisper_to_nats - hook-based real progress из
pyannote_diarization
Архитектурная схема
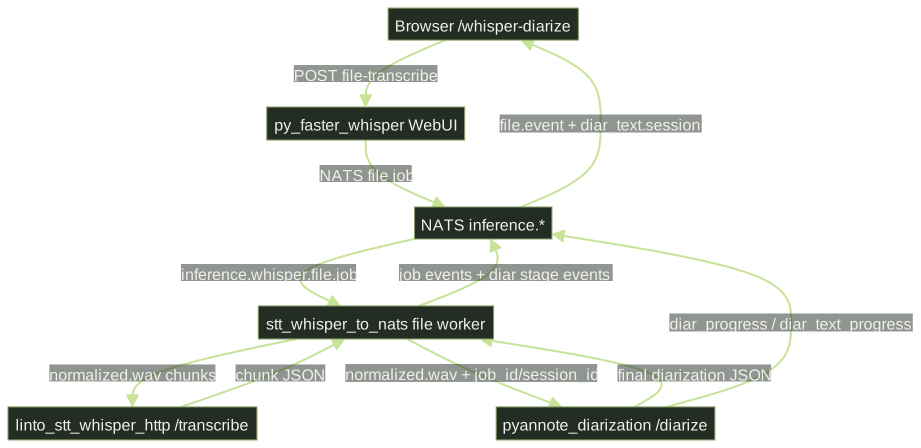
Исходный Mermaid
flowchart LR
    Browser["Browser /whisper-diarize"] -->|POST file-transcribe| WebUI["py_faster_whisper WebUI"]
    WebUI -->|NATS file job| NATS["NATS inference.*"]
    NATS -->|inference.whisper.file.job| Worker["stt_whisper_to_nats file worker"]
    Worker -->|normalized.wav chunks| LinTO["linto_stt_whisper_http /transcribe"]
    Worker -->|normalized.wav + job_id/session_id| Pyannote["pyannote_diarization /diarize"]
    LinTO -->|chunk JSON| Worker
    Pyannote -->|final diarization JSON| Worker
    Pyannote -->|diar_progress / diar_text_progress| NATS
    Worker -->|job events + diar stage events| NATS
    NATS -->|file.event + diar_text.session| Browser
Sequence Diagram
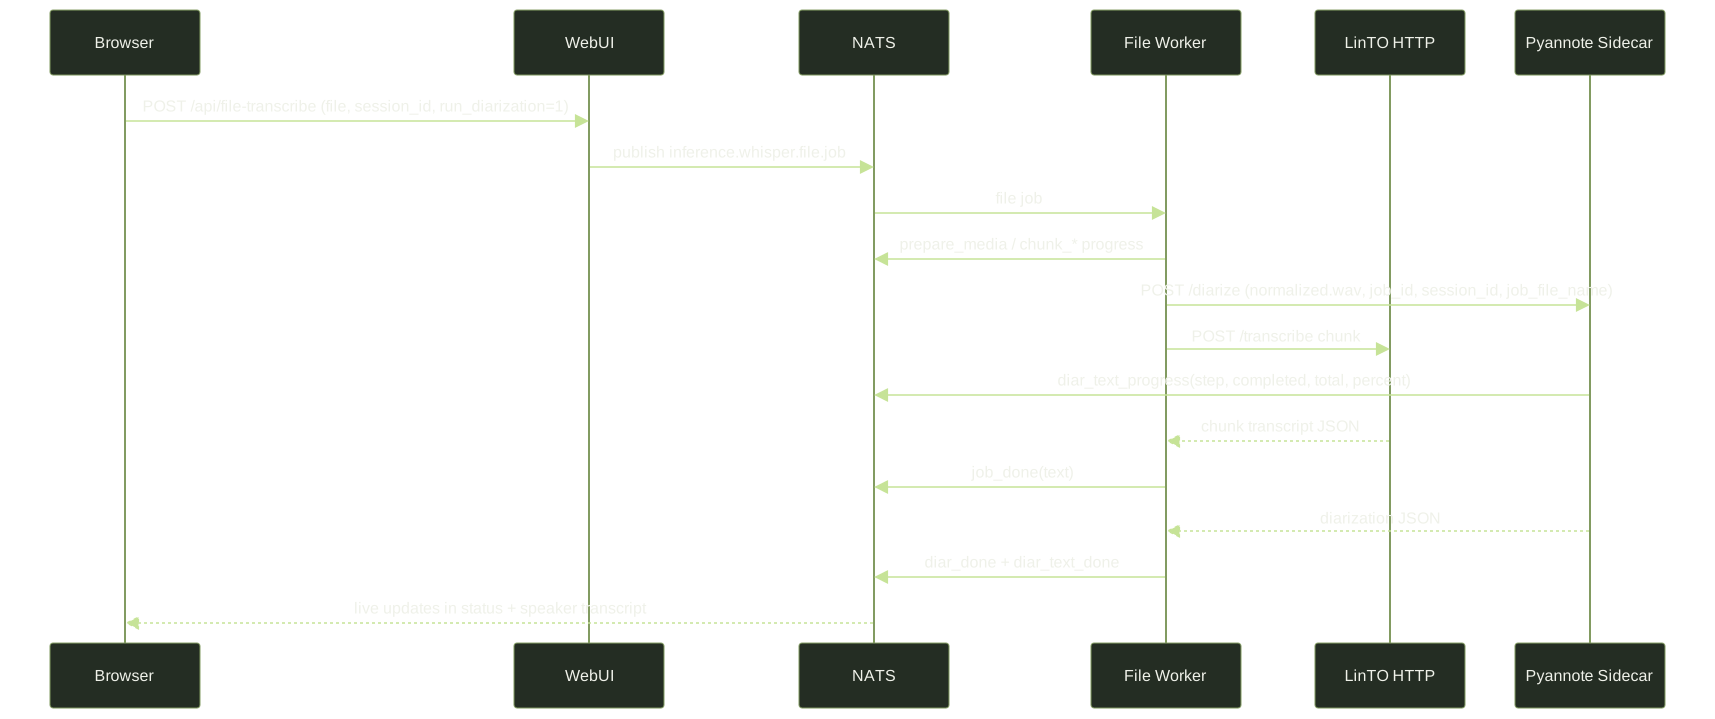
Исходный Mermaid
sequenceDiagram
    participant B as Browser
    participant W as WebUI
    participant N as NATS
    participant F as File Worker
    participant L as LinTO HTTP
    participant P as Pyannote Sidecar

    B->>W: POST /api/file-transcribe (file, session_id, run_diarization=1)
    W->>N: publish inference.whisper.file.job
    N->>F: file job
    F->>N: prepare_media / chunk_* progress
    F->>P: POST /diarize (normalized.wav, job_id, session_id, job_file_name)
    F->>L: POST /transcribe chunk #1..N
    P->>N: diar_text_progress(step, completed, total, percent)
    L-->>F: chunk transcript JSON
    F->>N: job_done(text)
    P-->>F: diarization JSON
    F->>N: diar_done + diar_text_done
    N-->>B: live updates in status + speaker transcript
UML State Diagram
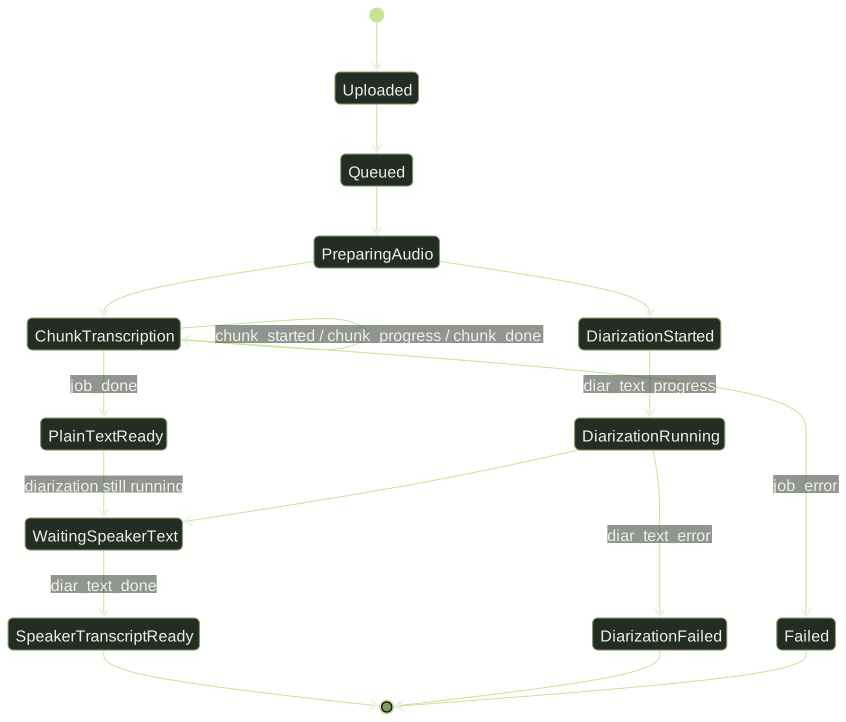
Исходный Mermaid
stateDiagram-v2
    [*] --> Uploaded
    Uploaded --> Queued
    Queued --> PreparingAudio
    PreparingAudio --> ChunkTranscription
    PreparingAudio --> DiarizationStarted
    ChunkTranscription --> ChunkTranscription: chunk_started / chunk_progress / chunk_done
    DiarizationStarted --> DiarizationRunning: diar_text_progress
    ChunkTranscription --> PlainTextReady: job_done
    PlainTextReady --> WaitingSpeakerText: diarization still running
    DiarizationRunning --> WaitingSpeakerText
    WaitingSpeakerText --> SpeakerTranscriptReady: diar_text_done
    DiarizationRunning --> DiarizationFailed: diar_text_error
    ChunkTranscription --> Failed: job_error
    SpeakerTranscriptReady --> [*]
    DiarizationFailed --> [*]
    Failed --> [*]
Data Exchange
1. Browser -> WebUI
- endpoint:
POST /api/file-transcribe - fields:
job_idsession_idlanguagerun_diarizationfile
2. WebUI -> NATS
- subject:
inference.whisper.file.job - payload: file job envelope with paths and flags for worker
3. Worker -> LinTO
- transport: HTTP
POST /transcribe - unit of work: one normalized audio chunk
- result: JSON with
textandwords
4. Worker -> Pyannote Sidecar
- transport: HTTP
POST /diarize - file: whole
normalized.wav - additive metadata fields:
job_idsession_idjob_file_name- speaker constraints:
num_speakersmin_speakersmax_speakers
5. Sidecar -> NATS
- structured subject:
inference.whisper.file.diar.event.<job_id>- text/session subjects:
inference.whisper.file.diar_text.event.<job_id>inference.whisper.file.diar_text.session.<session_id>
Progress events
diar_progressdiar_text_progress
Текущие поля progress payload:
typejob_idsession_idfile_namephase = diarize_runningstepcompletedtotalpercentdetails
Final events
diar_donediar_text_donediar_errordiar_text_error
Runtime Codemap
Краткая карта файлов вынесена отдельно в ../CODEMAP.md.
Главные entrypoints этого stack:
src/stt_whisper_to_nats.pysrc/pyannote_diarization_server.pysrc/webui/server.pysrc/webui/static/app.jsdocker/diarization-base/Dockerfiledocker/diarization/Dockerfile../rag-stack/stack/llm-models.drs
Проблемы, которые уже всплывали
1. TorchCodec / FFmpeg mismatch
Симптом:
Could not load libtorchcodecundefined symbol: aoti_torch_create_device_guard
Что оказалось причиной:
- несовместимая пара
torch 2.8.0+cu126иtorchcodec 0.11.0+cu126 - build graph держал старый override версии
torchcodec
Что сделали:
- зафиксировали
torchcodec 0.7.0+cu126 - убрали stale override
- сделали fail-fast smoke import на build/startup
2. Healthcheck restart loop
Симптом:
pyannote_diarizationстартовал, готовил pipeline, а потом контейнер пересоздавался примерно раз в минуту
Что оказалось причиной:
- сломанный inline
HEALTHCHECKс невалиднымpython -c
Что сделали:
- вынесли probe в
src.pyannote_healthcheck
3. Почему не удалось заюзать GPU
Симптом production runtime:
RuntimeError: NVML_SUCCESS == r INTERNAL ASSERT FAILED at "/pytorch/c10/cuda/CUDACachingAllocator.cpp":1131
Что важно:
- ошибка возникала не на import/load, а на первом реальном inference внутри pyannote
- перенос sidecar на отдельный MIG slice проблему не снял
- это указывает не на бизнес-логику diarization, а на связку:
- PyTorch CUDA allocator
- NVML
- MIG runtime
- host driver / CUDA compatibility
Почему текущий stable режим CPU:
- CPU даёт предсказуемый результат без allocator assert
- проблема GPU лежит ниже уровня приложения и не лечится только изменением HTTP/NATS логики
4. Почему в UI казалось, что процесс умер
Симптом:
- plain text уже готов, а speaker transcript долго не приходит
- в интерфейсе непонятно, жив ли процесс
Что оказалось причиной:
- progress шёл либо слишком грубо, либо терялся в общем status log
Что сделали:
- оставили coarse stage events из worker
- добавили real hook-based progress из pyannote sidecar по NATS
- вынесли progress в отдельный UI блок
Возможные варианты вернуть GPU
Ниже не гарантированный fix, а список практических направлений для отдельной диагностики:
- Уйти с MIG на полный GPU или на другой MIG profile и повторить pyannote inference.
- Проверить host driver / NVML against
torch==2.8.0+cu126runtime и пересобрать image при смене CUDA wheel set. - Протестировать allocator flags:
PYTORCH_CUDA_ALLOC_CONF=backend:cudaMallocAsyncPYTORCH_NO_CUDA_MEMORY_CACHING=1- Проверить ту же модель на другой версии PyTorch/CUDA wheels, а не только на
2.8.0+cu126. - Вынести pyannote на отдельный host без MIG, если GPU diarization действительно критична по latency.
До подтверждённого стабильного результата CPU остаётся опорным production режимом.