ASR и Monitor: исследование 30 октября 2026
После обсуждения решения обновлены: Nemotron исключён, принят план архива Opus, переработаны макеты Monitor. Актуальное согласование — версия 2. Фактические снимки ниже сохранены как результаты первоначального исследования.
Исследование выполнено без изменения исходников репозиториев, образов, runtime, GPU-разметки и конфигурации. Новые модели не загружались в GPU и не запускались. Локально созданы только этот отчёт, макет и материалы проверки.
1. NVIDIA Nemotron 3.5 Transcribe 30B-A4B
В нынешний раздел ASR рядом с действующими моделями — не помещается. На том же H100 возможен отдельный эксперимент с компактным GGUF в другом разделе. Это оценка размещения, а не подтверждённый запуск.
Фактическая память
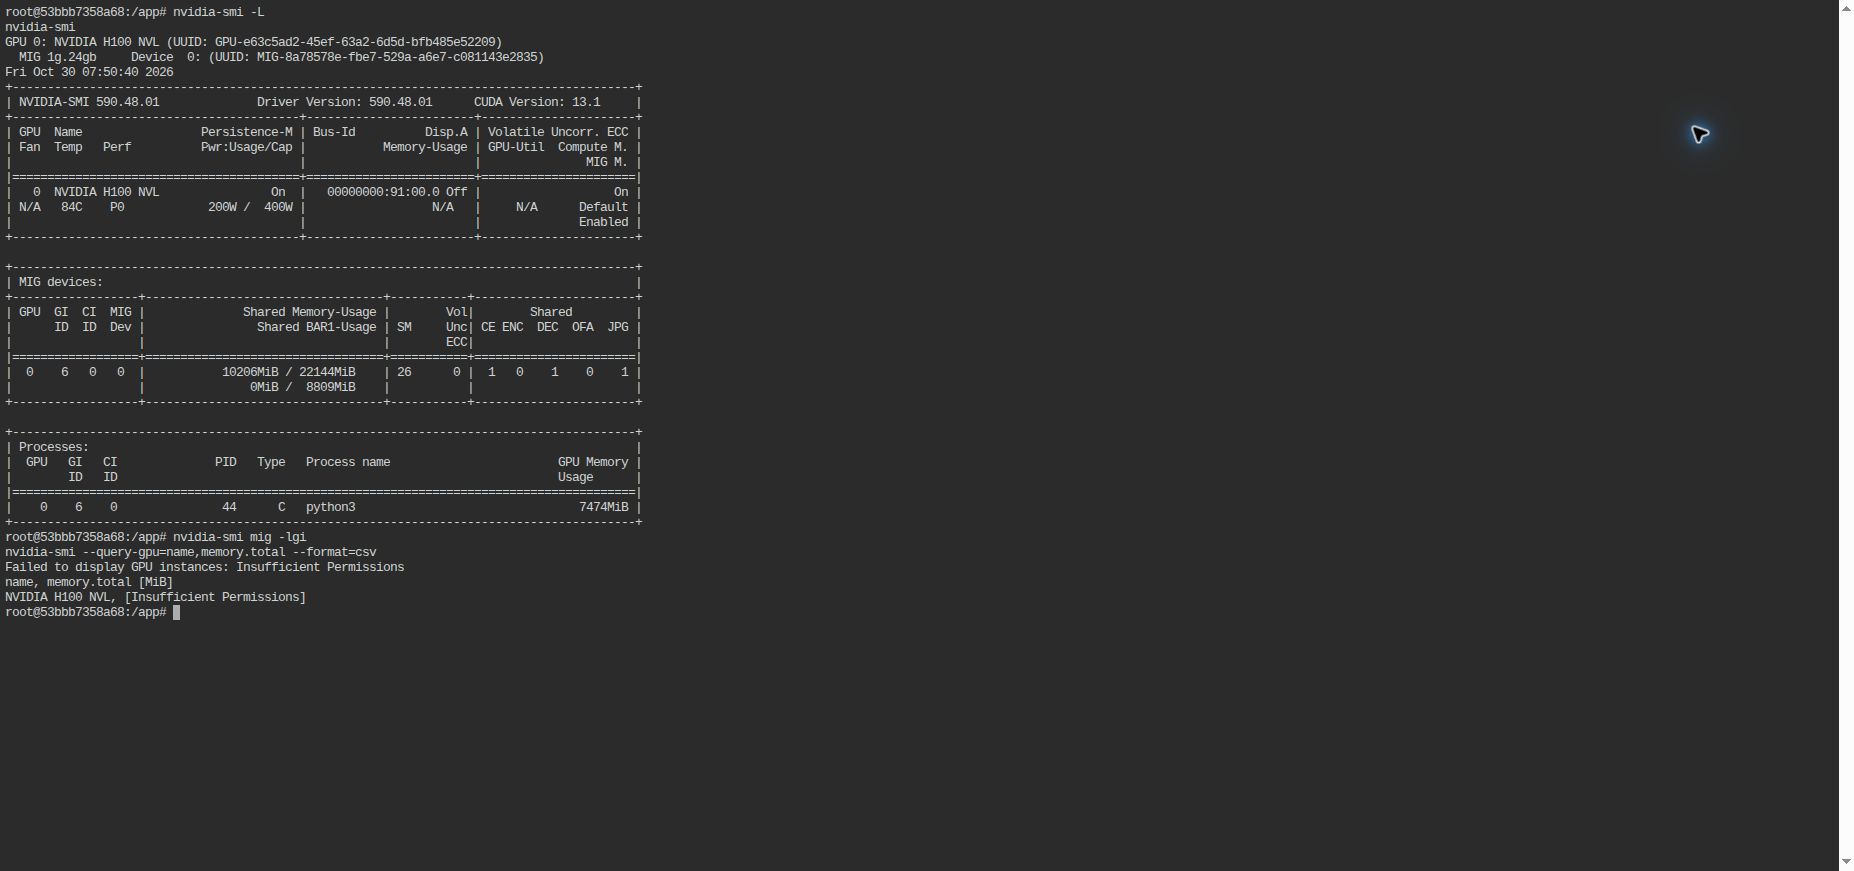
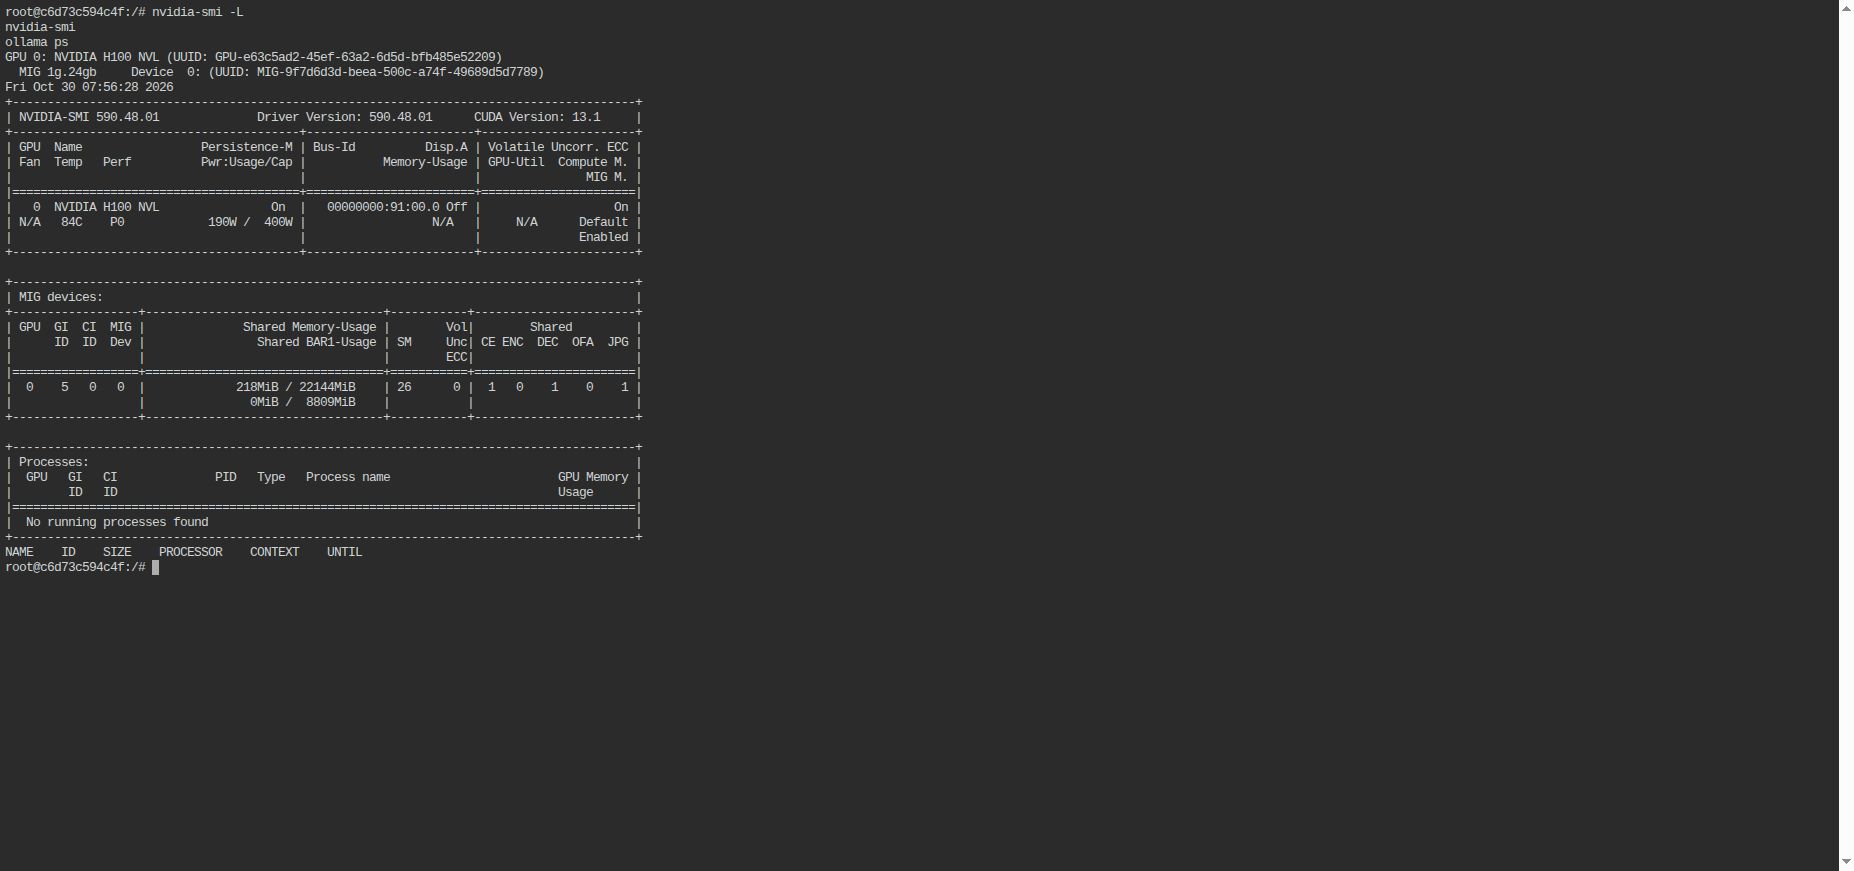
Через авторизованный H100 Insight выполнены только чтения nvidia-smi и ollama ps.
| Раздел | Наблюдаемая ёмкость | Занято | Свободно | Время снимка, Москва |
|---|---|---|---|---|
| ASR, MIG 1g.24gb, GI 6 | 22 144 МиБ | 10 206 МиБ | 11 938 МиБ / 11,66 ГиБ | 10:50:40 |
| Ollama, MIG 1g.24gb, GI 5 | 22 144 МиБ | 218 МиБ | 21 926 МиБ / 21,41 ГиБ | 10:56:28 |
Физическая карта — NVIDIA H100 NVL, memory.total=95830 MiB. В ollama ps нет загруженных моделей. Раздел Ollama остаётся предназначенным для Ollama: текущая свободная память не означает, что её можно занять без согласования. Свободную память разных MIG-разделов нельзя сложить для загрузки одной модели. Память остальных разделов отдельно не измерялась.
Подтверждения: ASR GPU, Ollama GPU. Сервис ASR в Insight называется webrtc-asr_streaming, версия 3.0.287, состояние 1/1 running. Историческое название сервиса не означает, что Chat Agent использует streaming-декодирование.
Размеры и варианты
В названии указаны активируемые параметры MoE, но в памяти нужны все веса. Модель содержит около 34B параметров, активны около 4,3B с учётом энкодера; русский язык поддерживается. Это распознавание готового аудио. Карточка NVIDIA.
Размеры ниже прочитаны из метаданных файлов. Это веса, не пиковая VRAM процесса; нужны дополнительные буферы и состояния.
| Вариант | Веса, десятичные ГБ | Веса, ГиБ | Вывод для имеющихся разделов |
|---|---|---|---|
| Официальный BF16 | 67,50 | 62,86 | Не помещается в 22 144 МиБ |
| Официальный FP8 | 34,67 | 32,29 | Не помещается в 22 144 МиБ |
| Официальный NVFP4 | 21,55 | 20,07 | Опубликованный путь рассчитан на Blackwell, не на наш H100 |
| AtomicChat AD-Q2_0_M + F16 encoder | 15,24 | 14,20 | Больше свободного ASR; кандидат для отдельного раздела |
| AtomicChat AD-Q2_0_L + F16 encoder | 17,22 | 16,04 | Кандидат для отдельного раздела; до буферов остаётся около 5,37 ГиБ |
| AtomicChat AD-IQ4_NL + F16 encoder | 21,35 | 19,88 | В разделе Ollama остаётся лишь около 1,53 ГиБ: запас слишком мал для уверенного вывода |
Hopper поддерживается официальным FP8-путём, а опубликованный NVFP4 требует Blackwell. FP8, NVFP4.
GGUF — community-квантизации AtomicChat, не измерения NVIDIA и не наши испытания. Обязательный encoder занимает ещё 1,67 ГБ и уже включён в таблицу. Автор сообщает пик 15,6 ГиБ для Q2_M на A100 в своей конфигурации. Его опубликованное сравнение качества не включает русский. На сильно сжатых вариантах нужно отдельно проверить ошибки слов, чисел и имён. Файлы и методика AtomicChat.
Это отдельный движок NeMo-Speech.cpp, не замена имени модели в faster-whisper. Его интерфейс принимает готовую запись, что подходит нашему batch-подходу. Однако документированы собственная проверка тишины и повтор пустого результата: перед интеграцией нужно разобрать эти ветки, чтобы не вернуть скрытое изменение поведения. Контракт SALM.
Рекомендация: если проверять Nemotron, начать с отдельного эксперимента Q2_L, коротких фраз до 30 секунд и одного задания. Не отнимать память у действующего ASR. Q2_M оставить вариантом при нехватке памяти, а не объявлять оптимальным по качеству. Без измерений нельзя обещать ускорение относительно Turbo: опубликованные 0,13 секунды на 30 секунд звука относятся к оптимизированному Blackwell/NIM-пути. Это не результат для нашего MIG H100 и GGUF. Условия NVIDIA benchmark.
2. GigaAM большего размера
По размеру весов GigaAM Multilingual Large 600M выглядит подходящим для нынешнего раздела ASR. Пик VRAM и скорость ещё не измерены.
Сейчас выбран ai-sage/GigaAM-v3, модель GigaAM-v3-e2e-rnnt, ревизия 7655ad717f8122257385bb4b2f373db3697e8680. Загрузка в нашем адаптере — .to(device).eval(), без явного .half(). Текущий адаптер.
У официального GigaAM Multilingual есть варианты 220M и 600M. Нужен именно large_ctc: large_ssl не является готовой заменой распознавания. Файл pytorch_model.bin ветки large_ctc — 2 341 592 643 байта, около 2,18 ГиБ. При свободных 11,66 ГиБ это существенно реалистичнее Nemotron. Активации, рабочие буферы, длительность фразы и параллельность нужно учитывать отдельно. Официальная модель, ветка large_ctc.
Это другой decoder: CTC вместо текущего RNNT. Нельзя обещать те же пунктуацию и нормализацию текста. Официальные результаты Large лучше Multilingual 220M, например RU FLEURS WER 4,4 → 3,0, но это не сравнение с нашим GigaAM-v3-e2e-rnnt. Сравнивать следует на одних PCM-фразах из Compare, отдельно по WER/CER, цифрам/именам, медиане и p95 времени модели, памяти. Увеличение модели само по себе не обещает меньшую задержку.
3. Какой Silero Web работает сейчас
Мы уже используем WebAssembly. Переписывать JavaScript-обвязку на Rust ради перехода «на WASM» не требуется.
Текущая цепочка: AudioWorklet → исходный PCM16 в ingress; независимая копия → libsamplerate → Worker → ONNX Runtime Web WASM → вероятности речи → простая машина границ фразы.
| Компонент | Проверено в исходниках |
|---|---|
| Движок | onnxruntime-web 1.31.1, WASM SIMD, CPU |
| Потоки | numThreads=1, proxy=false, отдельный Worker панели |
| Модель | ONNX из закреплённой ревизии Silero 6.2.3 1e261b036686cd0017d500ee96acd1c4ba572a9d |
| Размер ONNX | 2 327 524 байта |
| SHA-256 | 1a153a22f4509e292a94e67d6f9b85e8deb25b4988682b7e174c65279d8788e3 |
| Анализ | 16 кГц, кадр 512 отсчётов / 32 мс, контекст 64 отсчёта |
| Resampler | @alexanderolsen/libsamplerate-js 2.1.2, состояние сохраняется между кадрами |
| Границы | 200 мс pre-roll, 160 мс подтверждение начала, 450 мс пауза; пороги 0,65 / 0,50 |
Источники: адаптер, manifest, границы, версия upstream.
@ricky0123/vad-web — готовая браузерная обвязка вокруг Silero/ONNX Runtime, а не иной более быстрый inference. Наши захват, Worker и границы уже реализованы. Её внедрение может добавить дублирование управления аудио. Исходники проекта.
Именно указанный silero-vad-web 0.1.0 обозначен автором как unimplemented scaffolding и предусматривает JS-взаимодействие с ONNX Runtime/Transformers.js. Это не подтверждённый готовый Rust-движок с выигрышем скорости. Не путать его с другими crate с похожими именами. Документация указанного crate.
Рекомендация: оставить текущий путь. Если сокращать задержку, сначала измерять inference VAD и ожидание паузы раздельно. Замена обвязки не уберёт заданные 450 мс ожидания конца фразы; изменение этой паузы требует проверки качества границ.
4. Opus вместо PCM
В текущем контуре Chat Agent / расширение / ASR Compare передаётся бинарный PCM16 mono, не Opus. В выбранном потоке частота 48 кГц. Браузер отправляет исходные PCM-пакеты через NATS/WebSocket, ingress отдельно передаёт их в архив и подготовку распознавания. VAD не меняет записываемую ветку. Наличие WebRTC/TURN в соседнем репозитории само по себе не означает Opus в этом пути.
Исходники: captureController, natsSession, ingress browser_api.
Расчёт объёма без транспортных заголовков
| Формат | Битрейт | За минуту | За 5 секунд |
|---|---|---|---|
| PCM16, mono, 48 кГц | 768 кбит/с | 5,76 МБ | 480 кБ |
| PCM16, mono, 16 кГц | 256 кбит/с | 1,92 МБ | 160 кБ |
| Opus, условные 24 кбит/с | 24 кбит/с | 0,18 МБ | 15 кБ |
| Opus, условные 32 кбит/с | 32 кбит/с | 0,24 МБ | 20 кБ |
Относительно 48 кГц PCM это в 24–32 раза меньше, экономия 95,8–96,9% полезной нагрузки. Реальный битрейт VBR и доля сетевых заголовков зависят от настроек. Это арифметическая оценка, не benchmark.
Передавать Opus можно без перехода на WebRTC: браузерный AudioEncoder, бинарные пакеты существующего транспорта и декодер на приёме. Поддержку надо проверять через AudioEncoder.isConfigSupported. Opus добавляет кадровую задержку и расходы кодирования/декодирования; типичная регистрация WebCodecs задаёт 20 мс кадра. WebCodecs, регистрация Opus.
Ускорение текста из этого не следует. Микрофон передаёт PCM во время речи; к закрытию фразы почти весь звук уже находится на сервере. Модель всё равно работает с PCM, время ожидания паузы и её вычисления не исчезают. Выигрыш вероятнее на слабом канале и при загрузке готовых длинных записей. На хорошем соединении добавленный codec может даже увеличить задержку.
Ключевой конфликт: Opus lossy. Декодированный PCM не совпадёт побайтово с исходной записью микрофона. Передача параллельно Opus и исходного PCM для архива не экономит общий трафик. При сохранении нынешнего требования к точному архиву заменять транспорт на Opus не рекомендую. Изолированный A/B в Compare возможен как отдельное будущее исследование качества и end-to-end задержки, без объявления декодированного звука оригиналом. Формат Opus.
5. Макеты Monitor
Открыть локальный интерактивный макет. Он самодостаточен: без CDN, запросов к backend, PCM и автоматически выполняемого распознавания.
Два представления используют один и тот же набор 200 реальных наблюдений выбранного потока:
- Хронология: точное время, событие, направление, отправитель/получатель, полный адрес в деталях. События не прячутся в группах по типу.
- Связи: дорожки участников и отдельная стрелка на наблюдение; те же фильтры и выбранное событие. В макете отправка и получение намеренно не склеены без сохранённого доказательства связи.
Быстрые фильтры: Все / Chat UI (chat.ui.*) / NATS events (nats.events.*) / Аудио-ASR / Модель / Инструменты / Ошибки. Дополнительные: участник, отправка/получение, транспорт, тип, строка поиска по событию/subject/адресу/ID. Сортировка: сначала ранние, сначала поздние, по отправителю. Последний вариант явно обозначает потерю общего хронологического порядка.
Справа — выбранное наблюдение: полные имена, subject, ID с копированием и исходные метаданные снимка. Имена audio и asr помечены как роли без сохранённого точного имени сервиса. Длительность операции не подменяется разностью произвольных временных отметок разных хостов.
Предусмотрены светлая/тёмная темы и карточки для узкого экрана. Для production-проекта предлагается расширить существующий SessionSequence, а не добавлять новую систему событий, хранилище или компонентную архитектуру. Фильтры должны сохраняться при переключении представлений. На больших журналах фильтрация должна учитывать весь выбранный серверный диапазон, а не только уже загруженные страницы; макет явно показывает, что содержит часть журнала.
Проверка: 10 функциональных проверок в JSDOM прошли: фильтры, поиск, сортировка, пустой результат, выбор строки, переключение представлений/тем, одинаковый набор мобильных карточек. JS синтаксически корректен. Протокол проверки.
Ограничение: браузерная политика запретила открытие file://. Обход не выполнялся. Визуальная проверка макета в браузере, ширина 390 px и фактическая работа clipboard в браузере не подтверждены. Это проект интерфейса, не внедрённый и принятый production UI.
6. Куда делись схемы вызовов
Не потерялись. В Monitor отдельного запроса раскрывается «Выполнение · команды, инструменты и наблюдения», там есть Пары / Дорожки / Наблюдения. На запросе c1715cf4-213d-5b5b-93c2-3e02938585c0 реально открыты «Дорожки», показаны 76 наблюдений. Снимок существующей схемы.
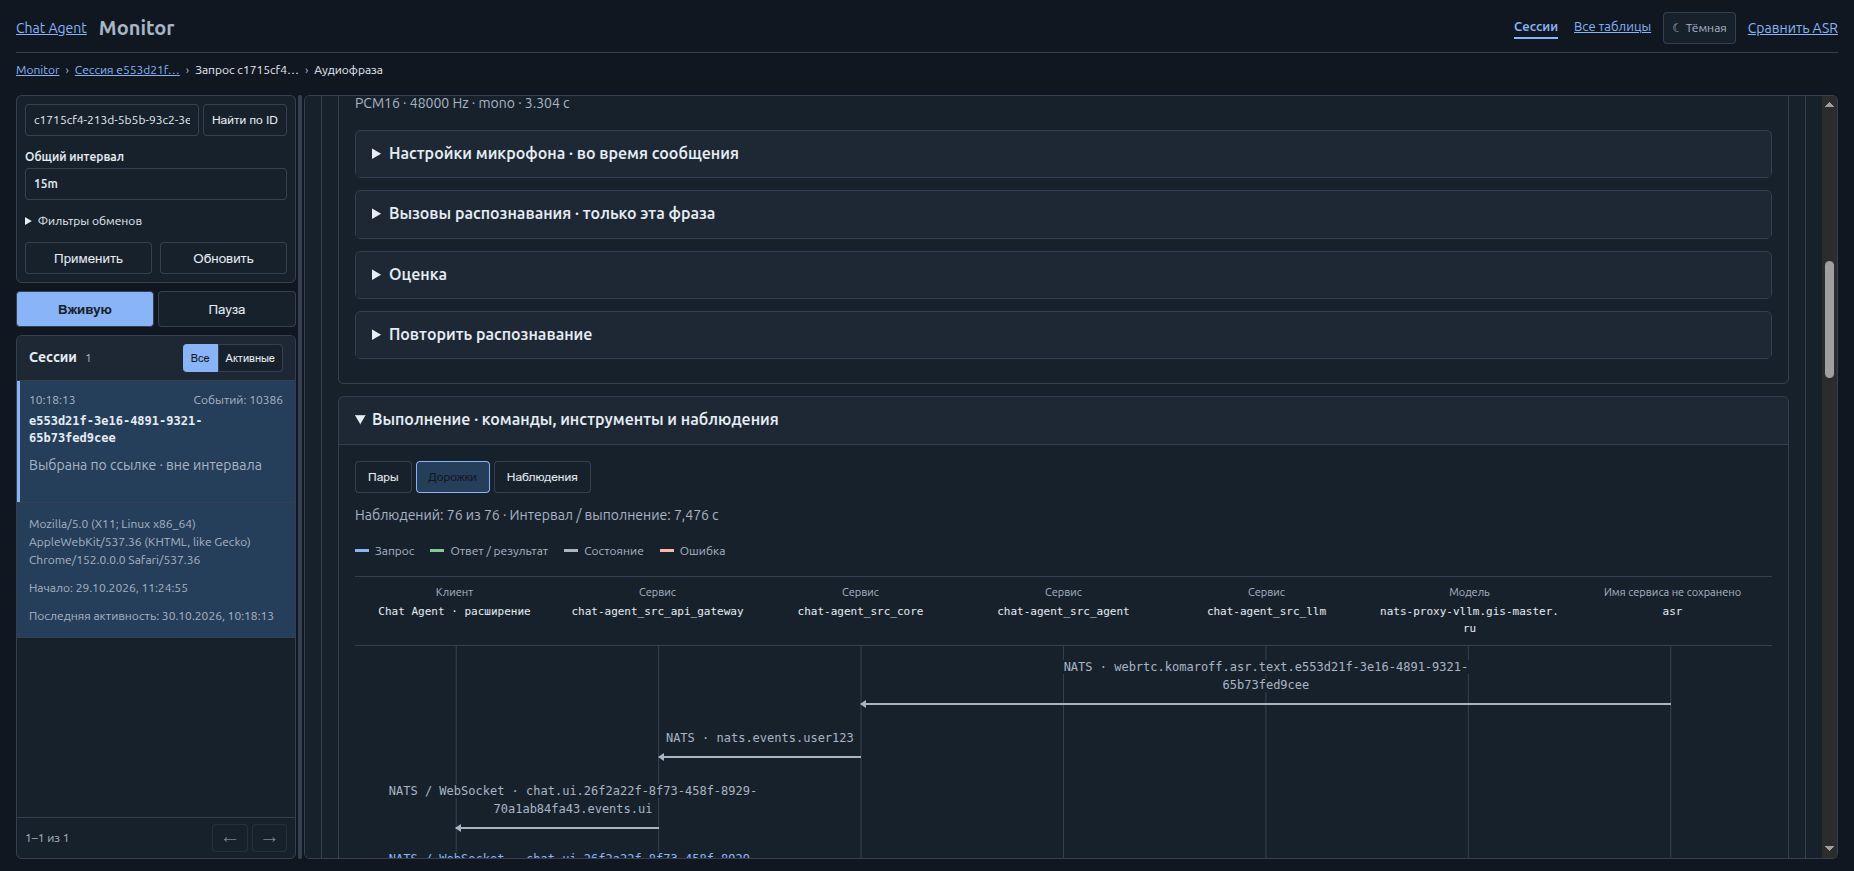
Открыть этот запрос с дорожками.
Причина отсутствия схемы на указанной странице потока подтверждена кодом: audioStreams.ts создаёт SessionSequence с фиксированным режимом 'events', без переключателя. В requests.ts переключатель есть. Поэтому достаточно дать потоку доступ к существующим представлениям и общим фильтрам.
Исходники: audioStreams.ts:107, requests.ts:199, sessionSequence.ts:11.
Проверенные источники и границы выводов
- Front/Core/Ingress: remote main
3e201723254ad48e53f6c9fa1eb9e9cca52c4338, совпадает с HEAD исследованного изолированного checkout. - ASR: remote main
ca436b4d7b3b2f2848743b6b04a8c33067798522; исследованный checkout1b72c6d3c6f62e01cddbea4fede81fef2ea34fd5, дерево совпадает с merge в main. - rag-stack: remote main
b98aab1dcf9318d9a527f36e9e560b0cd2c94cef; checkout647752719de7d402f91b9e36f78308ecce8931e2, дерево совпадает. GPU-placement сверялся с runtime, не только с DRS. - Локальный Repowise отстаёт (
6d48c68a…); выводы сверены непосредственно с актуальными исходниками. Индекс не перестраивался в read-only итерации. - NVIDIA BF16 model SHA
c17667641642c4265ff2b7037dd101b7d4567634; FP82b6209f89bec0da576d69183bfdabb3b6c05ade2; NVFP466c6adc4020179567074d0399cda2a4eeb2bb347. - AtomicChat GGUF SHA
dbd06c5cad7a2f33c8e06be2fb3ef814dbd9aa59; GigaAMlarge_ctcSHA3905cd51c3ed4e88c8edf33f3302969ba480a327. - Подтверждены: текущая свободная GPU-память, размеры опубликованных файлов, действующий браузерный WASM/PCM путь, существующие схемы Monitor.
- Не измерены: пик памяти новых моделей, их скорость/качество на наших данных, реальная задержка/качество Opus. Численные выигрыши inference не заявляются.
Ближайший разумный порядок после отдельного решения о внедрении: (1) GigaAM Large в Compare на одинаковом наборе PCM; (2) упрощение представления журнала через существующий компонент; (3) отдельный пробный Nemotron GGUF при выделенном бюджете памяти. Silero-обвязку и формат исходного архива сейчас менять оснований нет.