Whisper Diarization Stack
Этот документ описывает рабочий stack для /whisper-diarization, фактический обмен данными между сервисами и проблемы, которые проявились в production при запуске pyannote diarization.
Что сейчас считается рабочей схемой
- browser открывает
/whisper-diarization src/webui/server.pyпринимает upload и прямо в том же процессе запускаетFileJobWorkerService- перед стартом job на
/whisper-diarizationсервер делает submit-timeGET DIARIZATION_HEALTH_URL src/stt_whisper_to_nats.pyнормализует медиа вnormalized.wav, режет его на chunk-ы и отправляет chunk-ы вLINTO_HTTP_URL- при healthy diarization backend тот же runner параллельно отправляет компактный audio-only artifact в
DIARIZATION_HTTP_URL; вautoрежиме AAC-дорожка из MP4/M4A копируется без повторного encode - при unhealthy diarization backend job сохраняет
requested_diarization=true, но стартует сrun_diarization=falseи дружелюбной fallback reason - выбранный sidecar (
src/pyannote_diarization_server.py,src/sherpa_onnx_diarization_server.pyилиsrc/sortformer_diarization_server.py) выполняет speaker diarization и публикует совместимый JSON результат - browser получает:
- file job progress/result из
inference.whisper.file.event.<job_id> - diarization progress/result из
inference.whisper.file.diar_text.session.<session_id>, только еслиrun_diarization=true - HTTP snapshot и обычные file state event'ы с durable полями
requested_diarization,run_diarization,diarization_backend_status,diarization_fallback_reason
Текущий production runtime распределён между несколькими владельцами:
- public file WebUI и routes объявлены в
../webrtc-komaroff/stack/webrtc.drs - ASR (
linto_stt_whisper_http) работает на GPU и подключается через внешнийrag-stack - stack config для diarization вынесен во внешний
rag-stack/stack/diarization-models.drs pyannote_diarization_sharedоставлен для совместимого shared MIG режима, аpyannote_diarization_isolatedиспользует отдельный MIG slicesherpa_onnx_diarizationиsortformer_diarizationразвернуты как реальные sidecar-кандидаты с тем же/healthzи/diarizeконтрактом- image rollout для sidecar-ов отделён от остальных
voice-chat/*runtime images черезPYANNOTE_DIARIZATION_IMAGE_TAG,SHERPA_ONNX_DIARIZATION_IMAGE_TAG,SORTFORMER_DIARIZATION_IMAGE_TAG - progress speaker separation приходит двумя слоями:
- coarse stage events из
stt_whisper_to_nats - hook-based real progress из
pyannote_diarization - если backend отвечает
404/5xxили недоступен по transport, UI больше не показывает сырой ingress error, а деградирует в transcript-only на той же странице
Собственный stack/stack.drs теперь является воспроизводимым источником legacy CPU stack py_faster_whisper; deployment выполняется только из default branch. H100 модели и public WebRTC ingress сохраняют отдельных владельцев. CI image build, runtime stack и public ingress проверяются как отдельные proof layers.
Передача аудио в LinTO через NATS
LINTO_HTTP_URL задаёт настоящий backend URL, доступный receiver-у на H100.
LINTO_HTTP_PROXY_URL задаёт внутренний HTTP CONNECT endpoint requester-а.
Оба CPU stack используют CONNECT через существующий NATS bridge: multipart
передаётся бинарными потоковыми frames, а не одним JSON request envelope.
Обычный HTTP bridge в nats-proxy 0.4.16 теряет multipart upload, что приводит
к LinTO 422: file required; большие WAV также нельзя помещать в один NATS message.
CONNECT не требует новых ingress, SOCKS listener или изменения VPN/firewall.
При ошибке proxy прямого fallback нет. Без LINTO_HTTP_PROXY_URL сохраняется
прямой HTTP transport для локального запуска. Одна и та же функция отправляет
file chunks и live phrases; JSON/text ответы и multipart contract LinTO не меняются.
Для диаризации используется тот же src/model_transport.py: DIARIZATION_HTTP_URL
задаёт backend /diarize, а DIARIZATION_HTTP_PROXY_URL — CONNECT requester.
Это относится к общей функции diarize_http_json, используемой file/live,
staged и summary, и к diagnostics smoke. Обычный HTTP bridge может сохранять
multipart Content-Type, потеряв тело, поэтому pyannote возвращает 400: Could
not find starting boundary ещё до запуска модели. Зелёный /healthz не
подтверждает передачу файла.
В WebRTC shared pyannote принимает запрос на
http://diarization-models_pyannote_diarization_shared:8080/diarize через
http://web-rtc-komaroff_nats_proxy_pyannote_shared:7000. CPU sidecar в legacy
stack сохраняет прямой локальный HTTP без proxy. Bench/staged config хранит
отдельный proxy URL для выбранного backend; альтернативный backend не наследует
чужой proxy. При ошибке CONNECT прямого fallback нет, GPU placement не меняется.
Summary case выбирает transport по case_id и runtime из серверного
BENCH_CONFIGS_JSON, а не подменой Host на общем pyannote endpoint. Неописанный
runtime (например, isolated без своего route config) отклоняется явно; запрос
не отправляется молча в shared. Остальные request-level параметры сохраняются.
Альтернативные модели через NATS
WebRTC использует отдельную пару requester/receiver для каждого backend:
| Runtime | Proxy service (в обоих stack) | H100 backend в сети diarization-models_default |
Subject root на H100 |
|---|---|---|---|
| Pyannote shared | nats_proxy_pyannote_shared |
diarization-models_pyannote_diarization_shared:8080 |
inference.pyannote.shared |
| Pyannote isolated | nats_proxy_pyannote_isolated |
diarization-models_pyannote_diarization_isolated:8080 |
inference.pyannote.isolated |
| Sherpa ONNX | nats_proxy_sherpa_onnx |
diarization-models_sherpa_onnx_diarization:8080 |
inference.sherpa.onnx |
| Sortformer | nats_proxy_sortformer |
diarization-models_sortformer_diarization:8080 |
inference.sortformer |
Requester находится в web-rtc-komaroff, receiver — в llm-models.
Requester публикует to.<root>, принимает from.<root> в Core NATS;
H100 receiver слушает <root>.requests.> в JetStream. Существующие account
imports/exports покрывают эти roots; новые credentials и ingress не нужны.
В BENCH_CONFIGS_JSON /diarize содержит реальный H100 backend URL,
diarization_http_proxy_url — соответствующий requester на :7000.
Preflight GET идёт на /healthz того же requester-а и пересылается receiver-ом
в backend. Не заменять его на /healthcheck: этот путь проверяет только сам proxy.
Для /status/ используются backend health URL и явный *_HEALTH_PROXY_URL;
smoke передаёт файл через CONNECT и *_DIARIZE_PROXY_URL той же пары.
При новом запуске шага staged/summary сохранённый bench_config заново получает
пять transport-полей из текущего серверного конфига по case_id/runtime.
Старые прямые H100 URL больше не фиксируют маршрут известной модели навсегда.
Аудио, speaker hints и параметры эксперимента не меняются; уже исполняющийся
шаг и его внутренние retries используют выбранный в начале шага маршрут.
Legacy custom config без case_id не переинтерпретируется автоматически.
Прямая проверка 192.168.28.134:80 вынесена в группу network. Только при
DIAGNOSTICS_H100_INGRESS_INFORMATIONAL=1 она не влияет на service health:
реальная ошибка соединения остаётся видимой как FAIL, а группа помечена INFO.
Ошибка health или smoke любой модели по NATS по-прежнему ухудшает общий статус.
Sortformer: компилятор нужен в runtime
Triton создаёт host-side launcher при обработке аудио, поэтому
docker/sortformer/Dockerfile сохраняет
build-essential (компиляторы и libc headers) в конечном образе, а не только
на build-stage. Без него /healthz может быть зелёным, но /diarize возвращает
500: Failed to find C compiler после успешного приёма и декодирования файла.
Это дефект зависимости образа, не NATS, multipart или размещения GPU.
Приёмка требует реального /diarize smoke после публикации образа; один health
не проверяет отложенную компиляцию. CI, модель, CUDA и GPU selectors не меняются.
Архитектурная схема
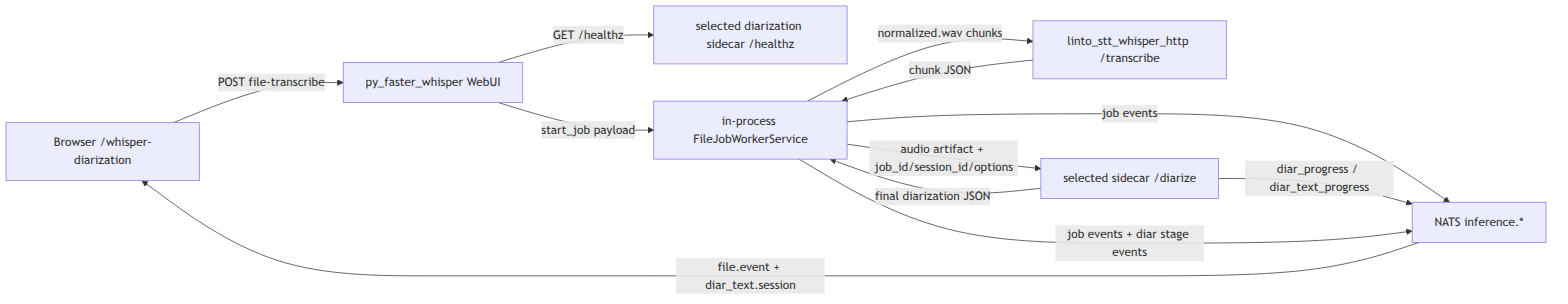
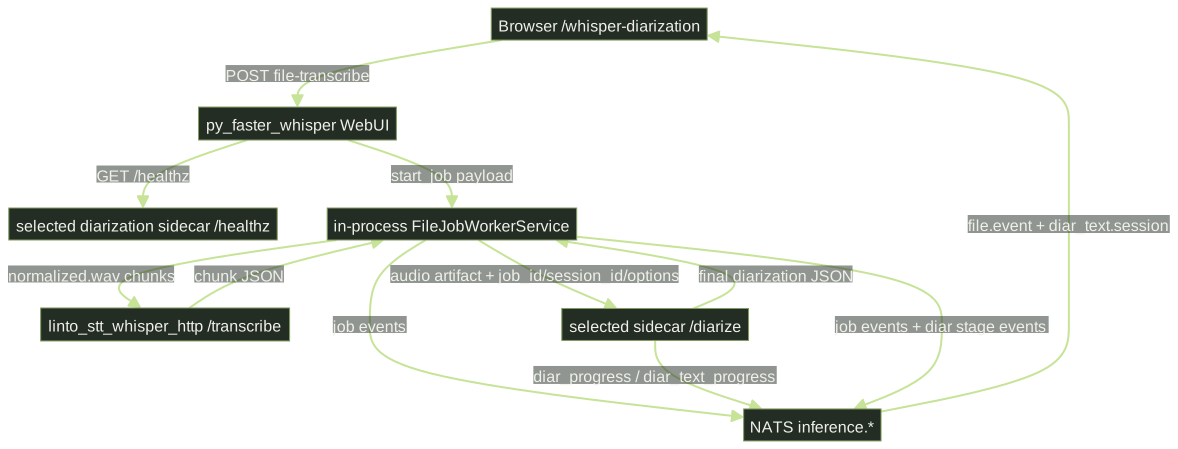
Исходный Mermaid
flowchart LR
    Browser["Browser /whisper-diarization"] -->|POST file-transcribe| WebUI["py_faster_whisper WebUI"]
    WebUI -->|GET /healthz| Health["selected diarization sidecar /healthz"]
    WebUI -->|start_job payload| Worker["in-process FileJobWorkerService"]
    Worker -->|normalized.wav chunks| LinTO["linto_stt_whisper_http /transcribe"]
    Worker -->|audio artifact + job_id/session_id/options| Pyannote["selected sidecar /diarize"]
    Worker -->|job events| NATS["NATS inference.*"]
    LinTO -->|chunk JSON| Worker
    Pyannote -->|final diarization JSON| Worker
    Pyannote -->|diar_progress / diar_text_progress| NATS
    Worker -->|job events + diar stage events| NATS
    NATS -->|file.event + diar_text.session| Browser
Sequence Diagram
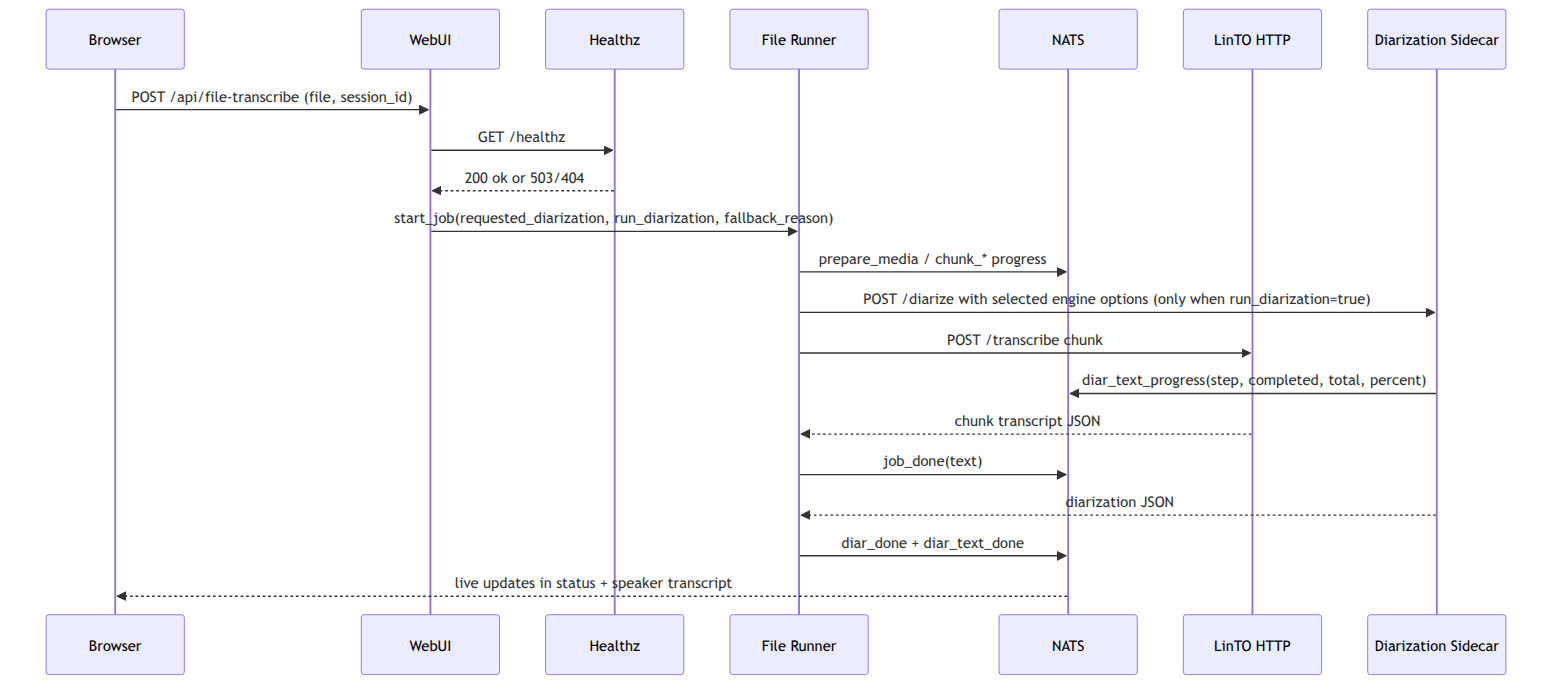
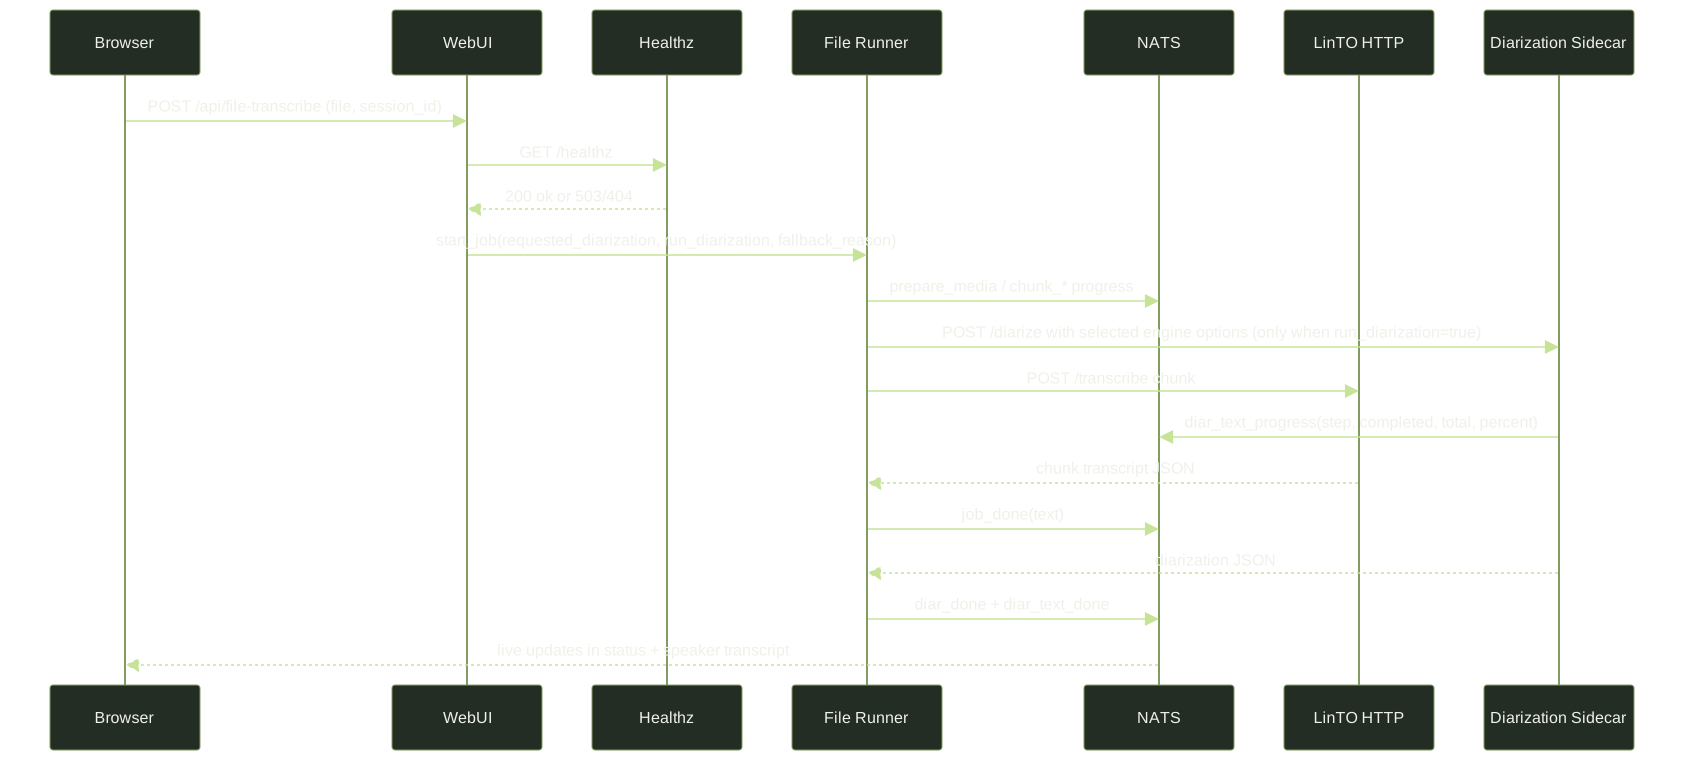
Исходный Mermaid
sequenceDiagram
    participant B as Browser
    participant W as WebUI
    participant H as Healthz
    participant F as File Runner
    participant N as NATS
    participant L as LinTO HTTP
    participant P as Diarization Sidecar

    B->>W: POST /api/file-transcribe (file, session_id)
    W->>H: GET /healthz
    H-->>W: 200 ok or 503/404
    W->>F: start_job(requested_diarization, run_diarization, fallback_reason)
    F->>N: prepare_media / chunk_* progress
    F->>P: POST /diarize with selected engine options (only when run_diarization=true)
    F->>L: POST /transcribe chunk #1..N
    P->>N: diar_text_progress(step, completed, total, percent)
    L-->>F: chunk transcript JSON
    F->>N: job_done(text)
    P-->>F: diarization JSON
    F->>N: diar_done + diar_text_done
    N-->>B: live updates in status + speaker transcript
UML State Diagram
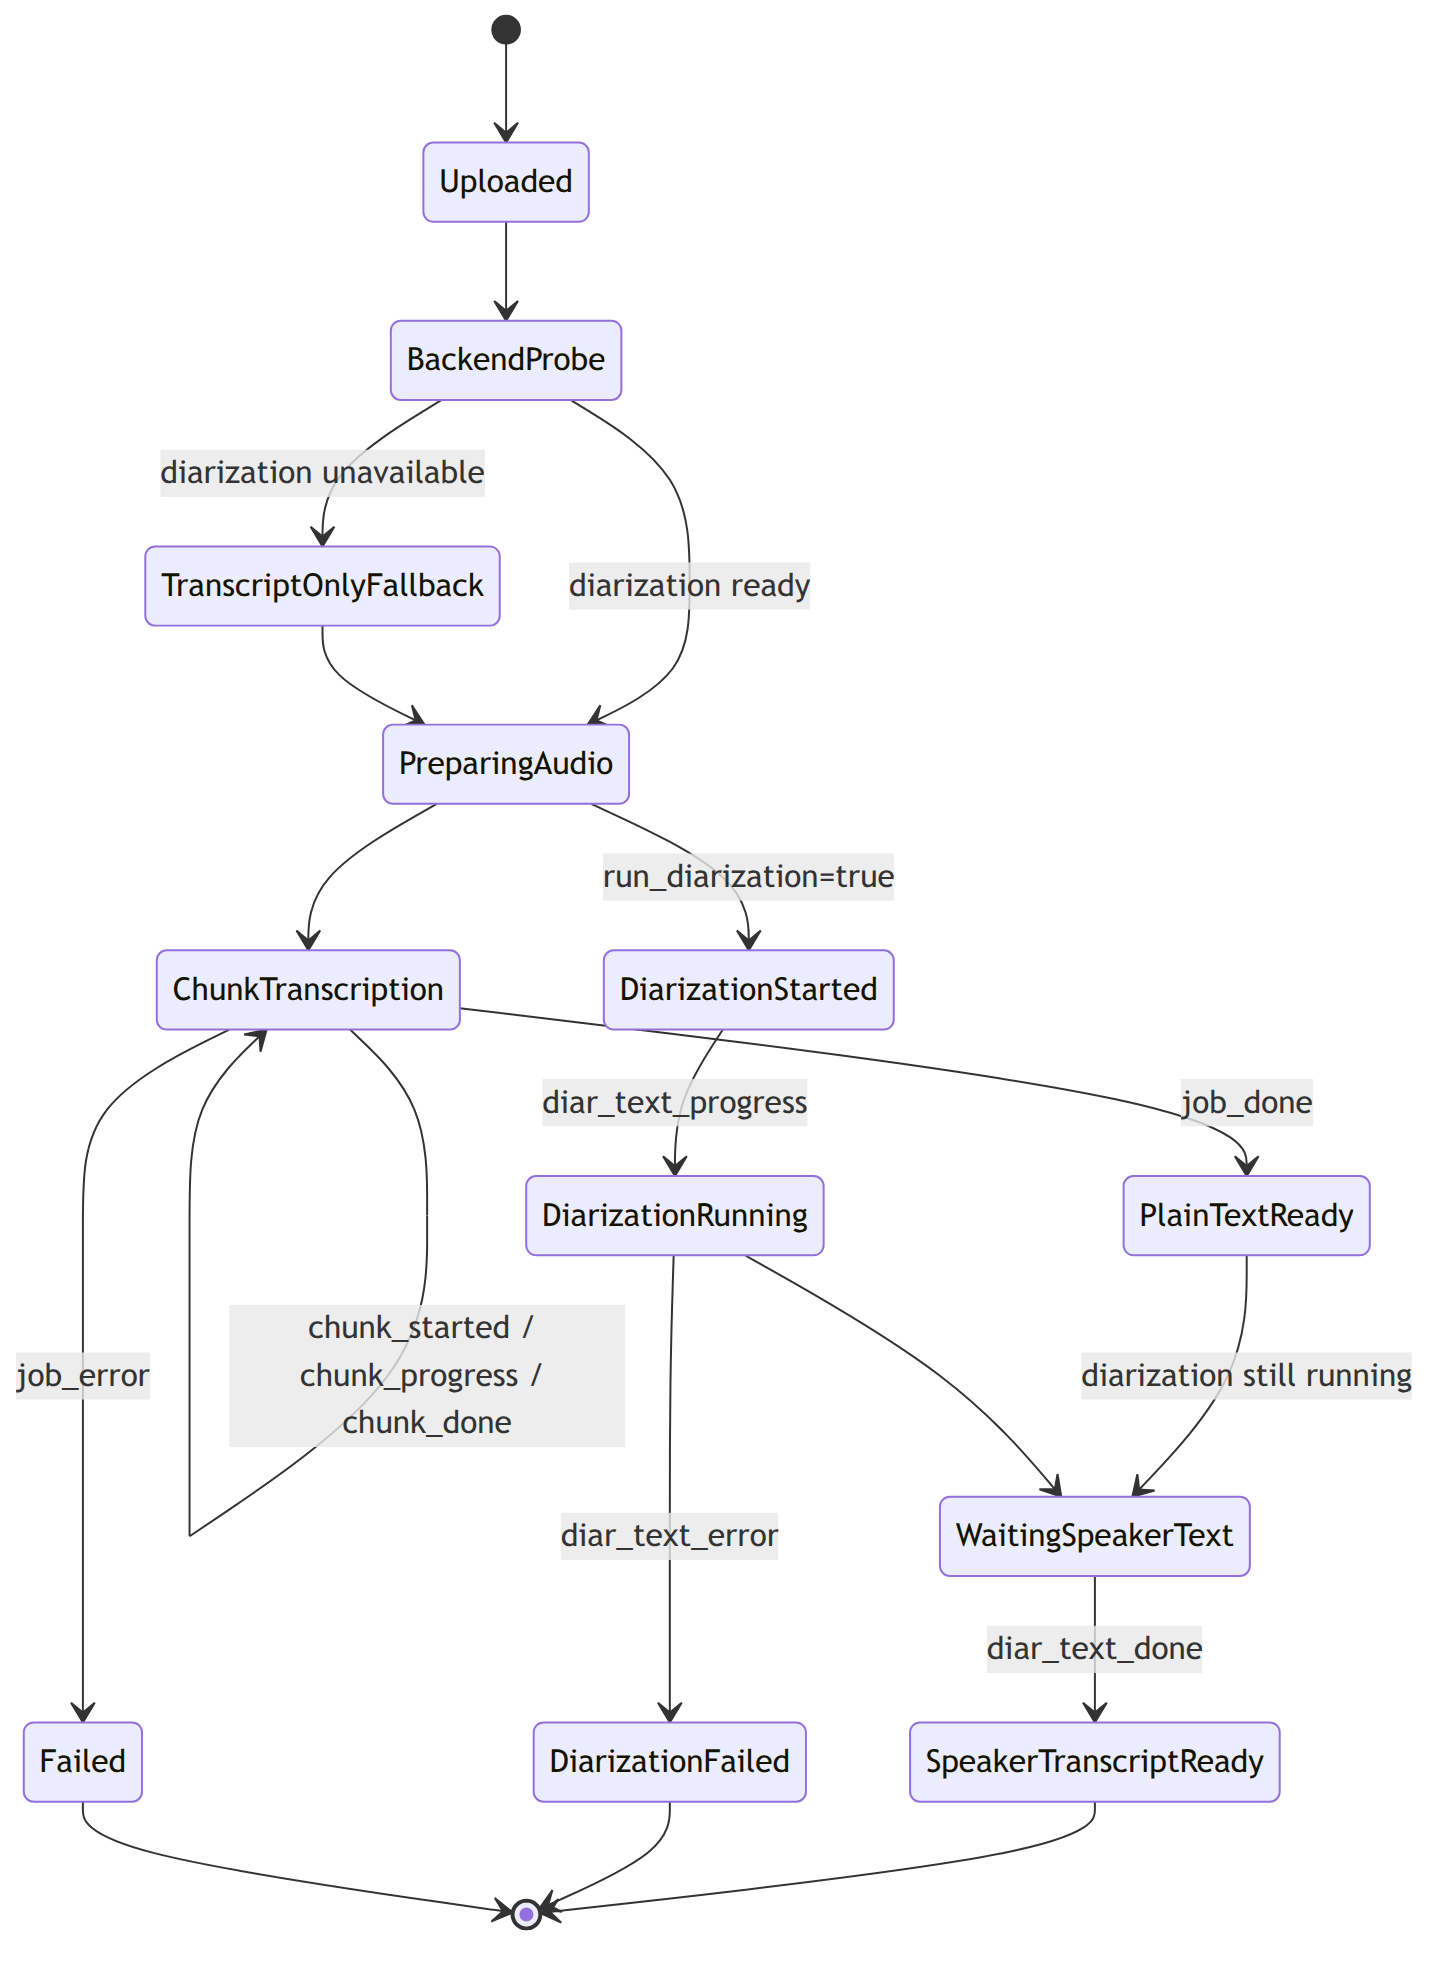
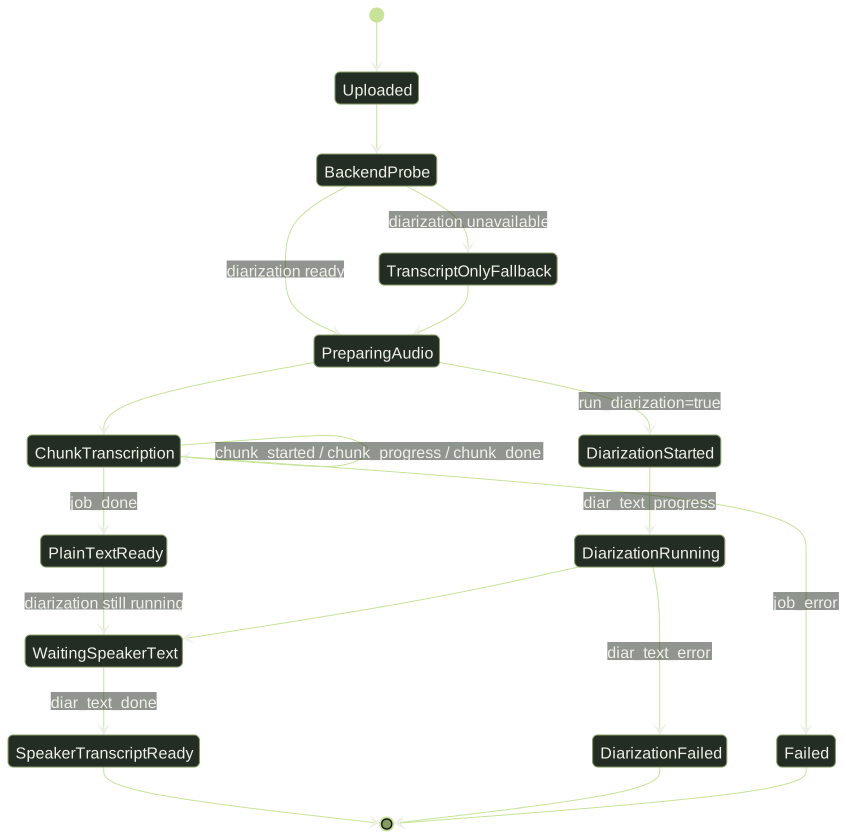
Исходный Mermaid
stateDiagram-v2
    [*] --> Uploaded
    Uploaded --> BackendProbe
    BackendProbe --> PreparingAudio: diarization ready
    BackendProbe --> TranscriptOnlyFallback: diarization unavailable
    TranscriptOnlyFallback --> PreparingAudio
    PreparingAudio --> ChunkTranscription
    PreparingAudio --> DiarizationStarted: run_diarization=true
    ChunkTranscription --> ChunkTranscription: chunk_started / chunk_progress / chunk_done
    DiarizationStarted --> DiarizationRunning: diar_text_progress
    ChunkTranscription --> PlainTextReady: job_done
    PlainTextReady --> WaitingSpeakerText: diarization still running
    DiarizationRunning --> WaitingSpeakerText
    WaitingSpeakerText --> SpeakerTranscriptReady: diar_text_done
    DiarizationRunning --> DiarizationFailed: diar_text_error
    ChunkTranscription --> Failed: job_error
    SpeakerTranscriptReady --> [*]
    DiarizationFailed --> [*]
    Failed --> [*]
Data Exchange
1. Browser -> WebUI
- endpoint:
POST /api/file-transcribe - fields:
job_idsession_idlanguagesyntax_postprocessfile- intent:
/whisper-trasncriptionвсегда даётrequested_diarization=false/whisper-diarizationвсегда даётrequested_diarization=true
2. WebUI -> Diarization Health Probe
- transport: HTTP
GET /healthz - host override:
DIARIZATION_HEALTH_HOST - outcome:
- health ok ->
run_diarization=true - backend unavailable / pipeline not ready ->
run_diarization=false, сохраняетсяdiarization_fallback_reason
3. WebUI -> Local File Runner
- transport: direct in-process call
file_runner.start_job(...) - durable flags:
requested_diarizationrun_diarizationdiarization_backend_statusdiarization_fallback_reason- worker копирует эти поля в каждый
file.event.<job_id>/file.session.<session_id>payload, поэтому browser и snapshot читают уже готовый state без дополнительных inference rules
4. Worker -> LinTO
- transport: HTTP
POST /transcribe - unit of work: one normalized audio chunk
- result: JSON with
textandwords
5. Worker -> Diarization Sidecar
- transport: HTTP
POST /diarize - file: compact audio-only artifact;
automay copy source AAC only while it stays under the upload guard, andnormalized.wavis used only for guarded short-file WAV mode - additive metadata fields:
job_idsession_idjob_file_name- speaker constraints:
num_speakersmin_speakersmax_speakers- engine-specific request options:
- pyannote: runtime URL,
segmentation_batch_size,embedding_batch_size,cluster_threshold, speaker hints - sherpa-onnx:
cluster_threshold, optional speaker count hint - Sortformer: profile, batch size, workers, long-window seconds, overlap seconds, maximum four speakers
- этот шаг пропускается, если submit-time probe уже решил
run_diarization=false
6. Sidecar -> NATS
- structured subject:
inference.whisper.file.diar.event.<job_id>- text/session subjects:
inference.whisper.file.diar_text.event.<job_id>inference.whisper.file.diar_text.session.<session_id>
Progress events
diar_progressdiar_text_progress
Текущие поля progress payload:
typejob_idsession_idfile_namephase = diarize_runningstepcompletedtotalpercentdetails
Final events
diar_donediar_text_donediar_errordiar_text_error
7. WebUI Snapshot -> Browser
- endpoint:
GET /api/file-job?job_id=... - snapshot fields:
requested_diarizationrun_diarizationdiarization_backend_statusdiarization_fallback_reason- те же поля уже присутствуют в file state event'ах; snapshot используется для дочитывания transcript и raw diarization artifacts
/whisper-diarizationфильтрует jobs поrequested_diarization, а не поrun_diarization, поэтому downgraded transcript-only job остаётся видимым на той же странице
Runtime Codemap
Краткая карта файлов вынесена отдельно в ../CODEMAP.md.
Главные entrypoints этого stack:
src/stt_whisper_to_nats.pysrc/pyannote_diarization_server.pysrc/sherpa_onnx_diarization_server.pysrc/sortformer_diarization_server.pysrc/webui/server.pysrc/webui/static/app.jsdocker/diarization-base/Dockerfiledocker/diarization/Dockerfile../rag-stack/stack/diarization-models.drs
Проблемы, которые уже всплывали
1. TorchCodec / FFmpeg mismatch
Симптом:
Could not load libtorchcodecundefined symbol: aoti_torch_create_device_guard
Что оказалось причиной:
- несовместимая пара
torch 2.8.0+cu126иtorchcodec 0.11.0+cu126 - build graph держал старый override версии
torchcodec
Что сделали:
- зафиксировали
torchcodec 0.7.0+cu126 - убрали stale override
- сделали fail-fast smoke import на build/startup
2. Healthcheck restart loop
Симптом:
pyannote_diarizationстартовал, готовил pipeline, а потом контейнер пересоздавался примерно раз в минуту
Что оказалось причиной:
- сломанный inline
HEALTHCHECKс невалиднымpython -c
Что сделали:
- вынесли probe в
src.pyannote_healthcheck
3. GPU rollout и shared MIG
Исторический симптом production runtime:
RuntimeError: NVML_SUCCESS == r INTERNAL ASSERT FAILED at "/pytorch/c10/cuda/CUDACachingAllocator.cpp":1131
Что важно:
- ошибка возникала не на import/load, а на первом реальном inference внутри pyannote
- перенос sidecar на отдельный MIG slice проблему не снял
- это указывает не на бизнес-логику diarization, а на связку:
- PyTorch CUDA allocator
- NVML
- MIG runtime
- host driver / CUDA compatibility
Что изменилось сейчас:
- stack снова таргетит GPU runtime для
pyannote_diarization - batch sizes жёстко зажаты до
1 - сервис делит MIG slice с LinTO, поэтому operational failures теперь могут быть двух типов:
- GPU/NVML/runtime проблема во время inference
- service availability проблема до старта inference
То есть приложение больше не предполагает, что GPU всегда стабилен. Оно проверяет доступность backend-а заранее и умеет не блокировать transcription, если diarization backend сейчас недоступен.
4. Ingress 404 и backend unavailable
Симптом:
Speaker transcript error (worker_error): Diarization HTTP error 404: 404 page not found- либо пользователь видел plain text, но не понимал, почему speaker branch не стартовал
Что оказалось причиной:
- ingress route был жив, но за ним не было работающего
pyannote_diarization - возможные operational причины:
- сервис оставлен в
scale 0 - image tag отсутствует в registry
- backend ещё грузится и отдаёт
503 pipeline_not_ready
Что сделали:
- ввели submit-time health probe через
DIARIZATION_HEALTH_URL 404/5xxи transport errors теперь схлопываются в дружелюбноеSpeaker diarization unavailable: diarization backend is not reachable./whisper-diarizationсохраняетrequested_diarization=true, но может запускать job сrun_diarization=false- UI остаётся на diarization page, показывает transcript-only fallback и не ждёт speaker transcript бесконечно
5. Почему в UI стало понятнее, что происходит
Сейчас одновременно работают две защиты:
- coarse stage events из worker
- real hook-based progress из pyannote sidecar по NATS
Если diarization реально не стартовал, UI больше не маскирует это под "ещё подождите", а показывает явную fallback reason.
Текущие operational риски
pyannote_diarizationтеперь деплоится с отдельнымPYANNOTE_DIARIZATION_IMAGE_TAG; это убирает coupling с pinnedVOICE_CHAT_IMAGE_TAG, но требует держать отдельный image tag в registry.- shared MIG с LinTO остаётся узким местом для latency и memory pressure.
- health probe решает только доступность backend-а в момент submit. Если backend умрёт посередине job, transcription завершится, а diarization уйдёт в friendly error.
Для отдельной GPU-диагностики остаются те же практические направления:
- Держать три реальные ветки benchmark: pyannote shared/isolated, sherpa-onnx CPU/ONNX, Sortformer GPU/NeMo.
- Проверить host driver / NVML against
torch==2.8.0+cu126runtime и пересобрать image при смене CUDA wheel set. - Протестировать allocator flags:
PYTORCH_CUDA_ALLOC_CONF=backend:cudaMallocAsyncPYTORCH_NO_CUDA_MEMORY_CACHING=1- Проверить ту же модель на другой версии PyTorch/CUDA wheels, а не только на
2.8.0+cu126.