py_faster_whisper: потоковая речь, файлы и разделение говорящих
Архитектурный снимок от 16 сентября 2026 года: main 21c85b0c7bc7a96497ce78ec2ead44b113f18db6. Код и конфигурация сверены с checkout. Незакоммиченные прежние документы и презентация сохранены; они не использовались как источники.
Техническая презентация · Реестр доказательств · Проверка материалов
Что здесь исполняется
Сервис принимает живой PCM-поток через NATS или файл через WebUI. Потоковый путь выделяет фразы с помощью VAD и отправляет их на LinTO HTTP. Файловый путь нормализует аудио, распознаёт фрагменты, при необходимости получает интервалы говорящих и соединяет их со словами. Браузер получает состояние задания и результат через HTTP и NATS.
Название репозитория не означает, что основной bridge сам загружает faster-whisper. Проверенный путь распознавания вызывает внешний LinTO. Локально работают обработка аудио, VAD, управление файлами и совместимые diarization sidecars — сервисы определения говорящих.
Все описания ниже имеют статус VERIFIED / SOURCE, если не указано иное. Реально загруженные GPU-модели, версии deployed images и их производительность — UNKNOWN. Этот аудит не запускал inference на рабочем кластере.
Один репозиторий участвует в нескольких стеках
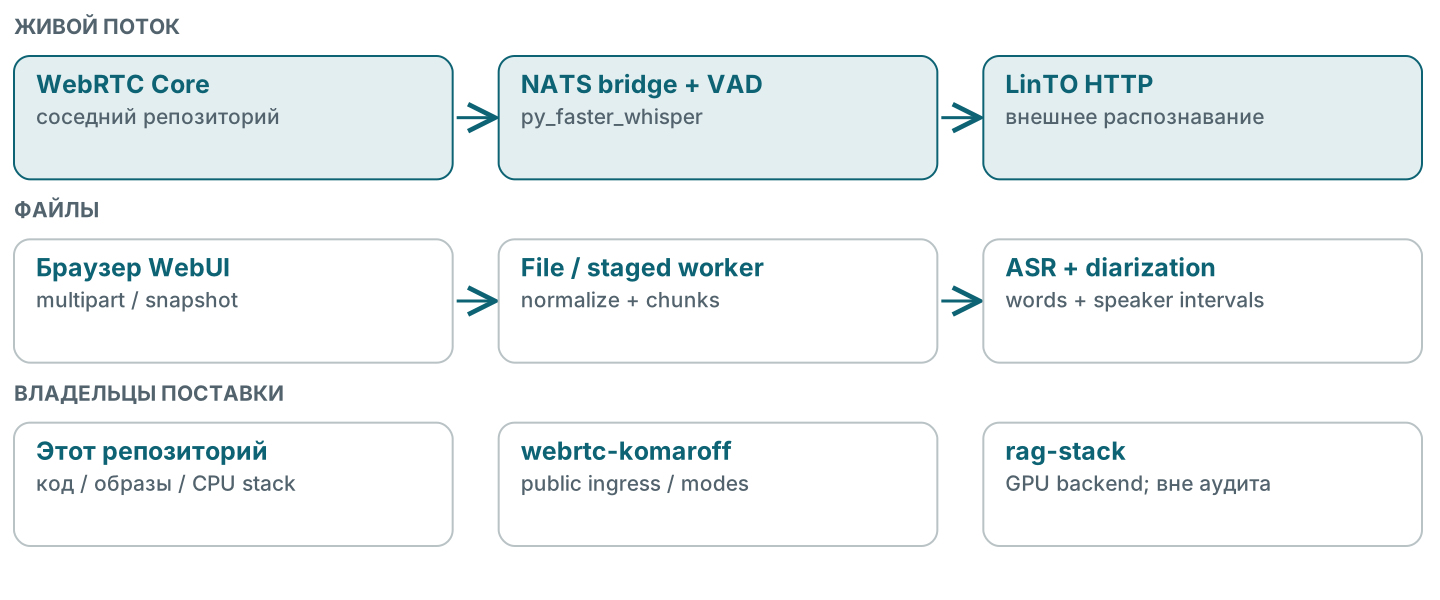
Проект владеет bridge, WebUI, файловыми менеджерами, тремя sidecar-реализациями и их образами. Собственный stack/stack.drs описывает legacy CPU stack из пяти сервисов: LinTO proxy, bridge и три diarization sidecar. Слово legacy здесь относится к владельцу и конфигурации CPU-стека, а не доказывает отсутствие пользователей.
Соседний webrtc-komaroff объявляет публичные WebUI ingress, разные page modes и shared job-lock service. Внешний rag-stack владеет H100 backend и принимающими proxy. Наличие URL или image в DRS подтверждает ожидаемую топологию, но не доступность backend.
Карта кода следует двум разным входам
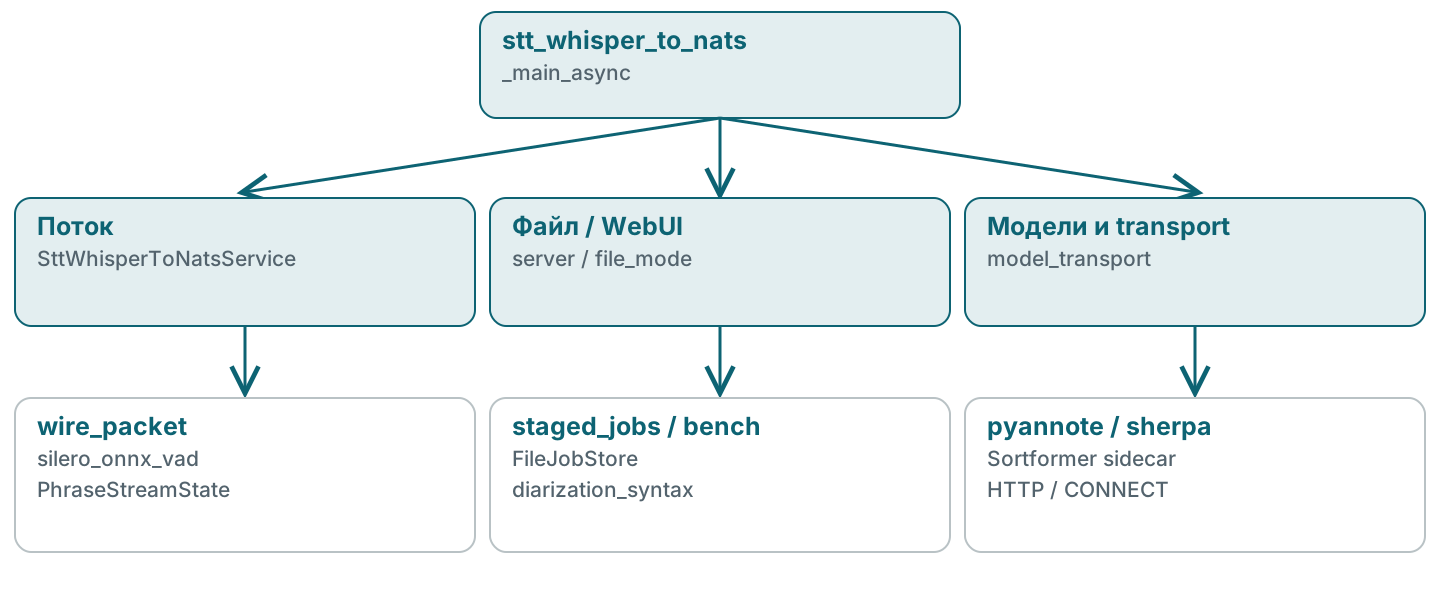
| Область | Что получает и делает | Что возвращает / хранит |
|---|---|---|
src/stt_whisper_to_nats.py |
_main_async запускает bridge и/или WebUI; stream/file orchestration |
NATS результаты, задачи в памяти |
src/utils/wire_packet.py |
разбирает metadata + PCM | metadata, нормализованный float32 audio |
src/utils/silero_onnx_vad.py |
ONNX VAD | интервалы речи |
src/webui/server.py |
HTTP upload, snapshots, запуск шагов | 202/job_id, страницы и JSON |
src/webui/file_mode.py |
настройки, FileJobStore, ffmpeg, chunks, LinTO calls | WAV, words, text, state.json |
src/webui/staged_jobs.py |
отдельные transcribe/diarize/combine | повторно используемые промежуточные результаты |
src/diarization.py, diarization_syntax.py |
интервалы говорящих + слова | attributed words, speaker turns |
src/model_transport.py |
direct HTTP либо CONNECT proxy | бинарный multipart без JSON-обёртки |
src/*_diarization_server.py |
pyannote / sherpa-onnx / Sortformer | совместимые HTTP results и health |
src/webui/diagnostics.py, bench.py |
проверка зависимостей, сравнение прогонов | check results, timing/RTF и quality proxies |
Entry point: python -m src.stt_whisper_to_nats. Отдельного src.main нет. Флаги STREAM_BRIDGE_ENABLED и WEBUI_ENABLED выбирают процессы внутри этого entrypoint; если выключены оба, запуск завершается ошибкой.
Живой звук сначала превращается во фразы
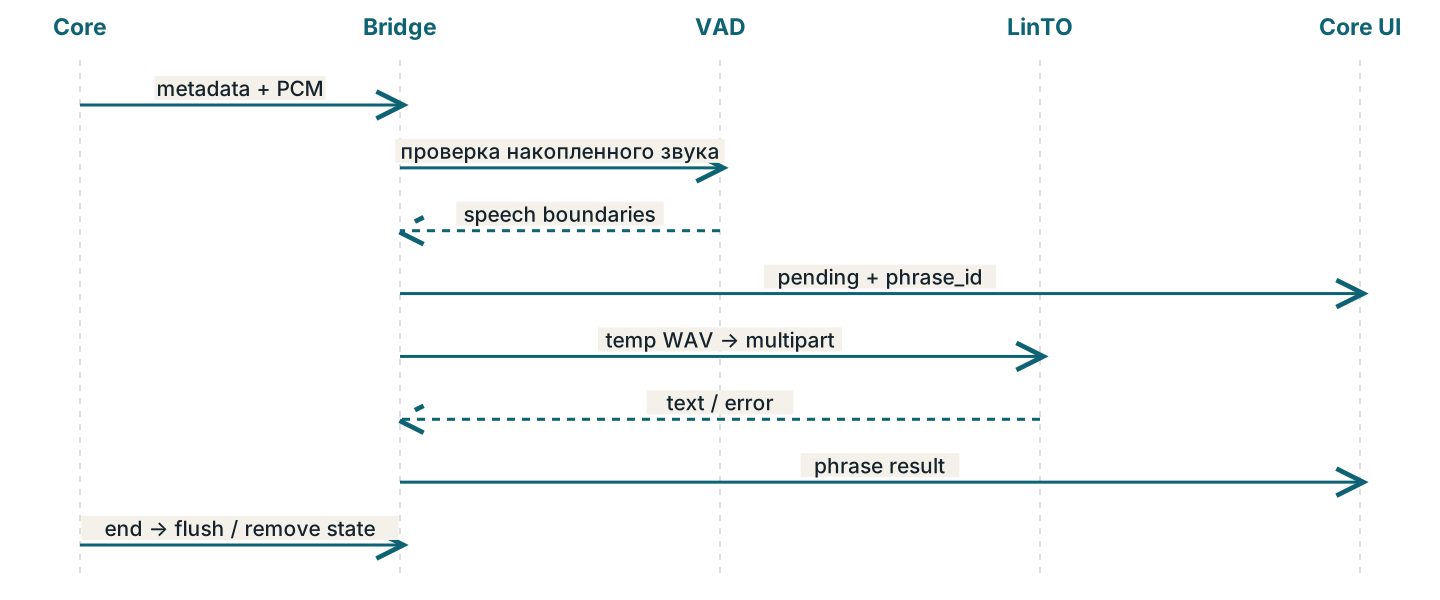
Bridge слушает ASR_IN_PREFIX>. Суффикс входного subject определяет выходной канал. Для каждого потока в памяти создаётся PhraseStreamState: список фрагментов, число samples, sample rate, session_id и lock.
Проверка буфера вызывает Silero VAD. Когда после речи набрана пауза или пришёл end, bridge формирует фразы, пишет временный WAV и отправляет его LinTO. Перед обращением публикуется pending; затем — текст с phrase_id либо ошибка. WAV удаляется в finally.
Общий semaphore ограничивает число одновременных запросов распознавания, но задачи создаются до входа в semaphore. INFERRED: длительное замедление backend может увеличить число ожидающих задач и временных файлов. Полного ограничения admission для входного потока здесь не найдено.
Есть и особенность репликации: wildcard subscription обычная, без queue group, а VAD-буфер локален. Две обычные реплики получат один поток целиком; простая замена на случайную queue group разнесёт его кадры между репликами. Нужен владелец потока или явное шардирование по session, прежде чем увеличивать replicas.
Источник: SttWhisperToNatsService.
Файловый запрос возвращает ID раньше результата
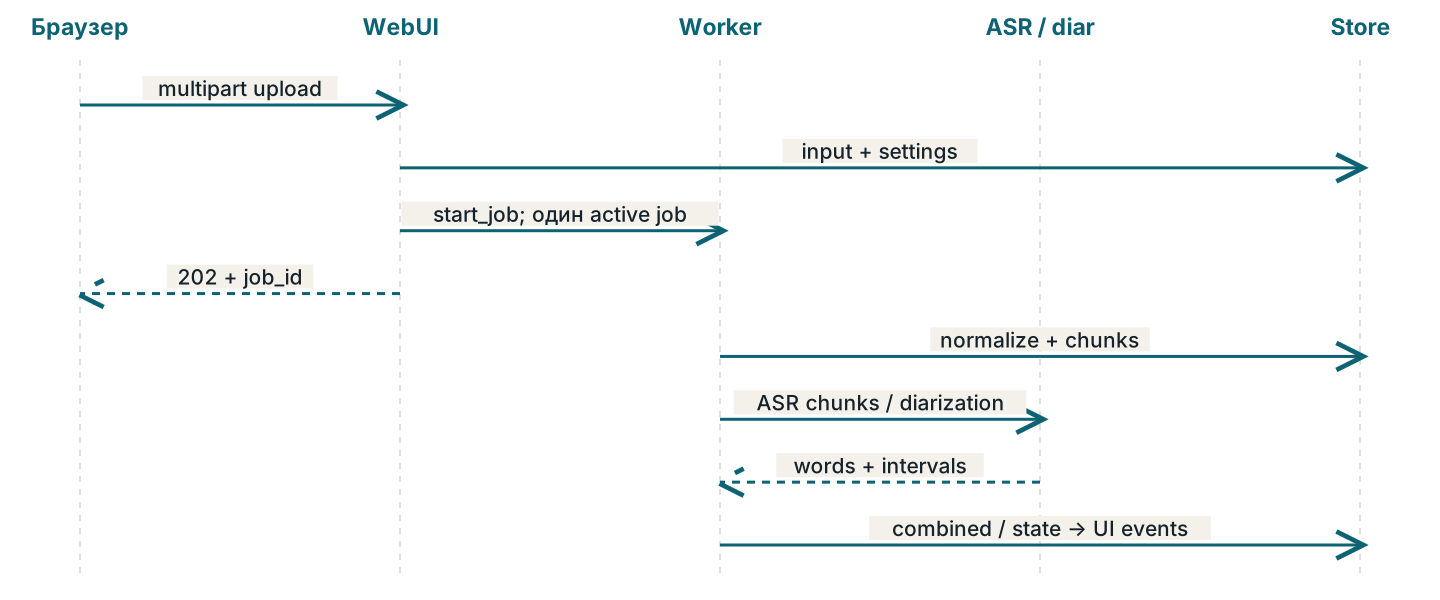
HTTP handler читает multipart и пишет исходный файл в каталог задания. Если включён общий lock, сначала получает lease на загрузку. После проверки настроек запускает in-process worker и отвечает 202 с job_id. Это фоновая asyncio-задача, а не подтверждённая очередь с восстановлением после рестарта.
FileJobWorkerService.start_job отменяет своё предыдущее активное задание, затем получает lock на обработку. Поэтому в одном экземпляре сохраняется один активный job. Новый запрос не означает автоматическое накопление независимых заданий.
Worker нормализует звук, распознаёт фрагменты и может параллельно запустить diarization. После получения обоих результатов слова получают говорящих по временным интервалам. В обычном режиме недоступность diarization может привести к распознаванию без говорящих: handler явно возвращает requested_diarization, run_diarization и причину downgrade. Это продуктовый fallback; transport при ошибке CONNECT на direct HTTP не переключается.
Пошаговый режим сохраняет дорогие промежуточные результаты
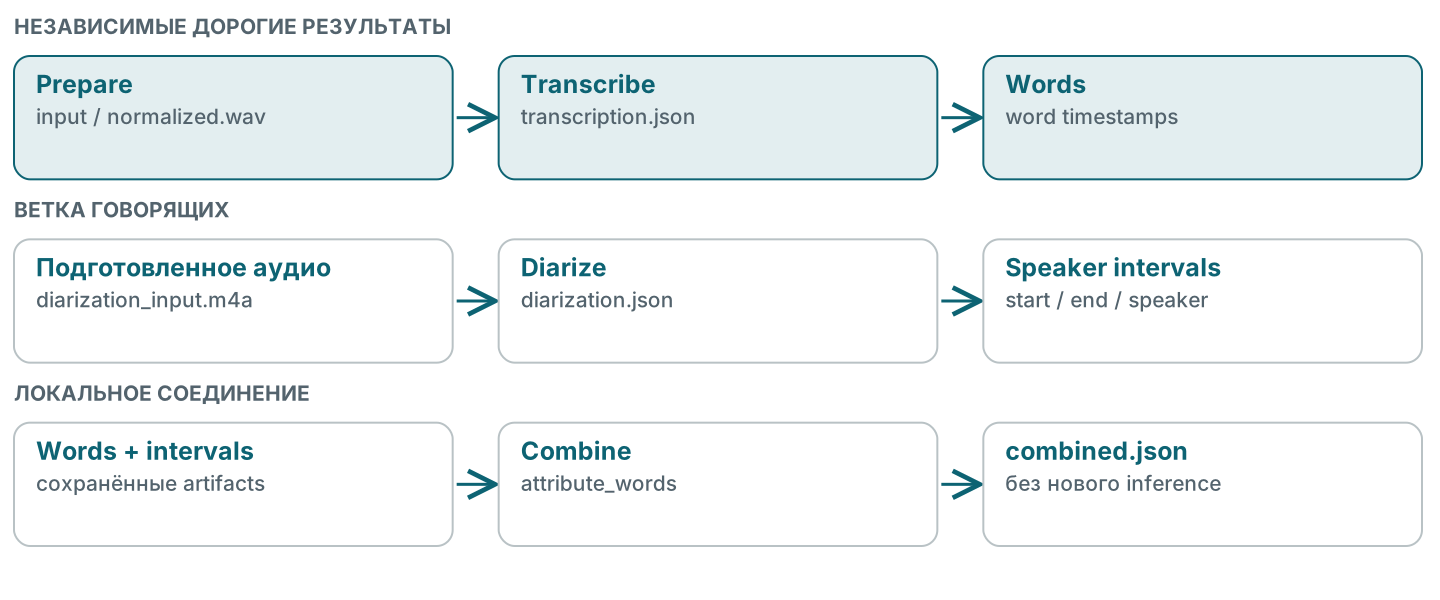
Prepare создаёт исходные артефакты и state. Transcribe сохраняет words и transcription payload. Diarize сохраняет интервалы говорящих. Combine читает оба результата и пересчитывает сопоставление локально.
Повторный Combine не запускает ASR или diarization. Это уже реализованное сокращение дорогих вызовов, а не предложение на будущее. Перезапуск Transcribe или Diarize инвалидирует зависимый combined artifact; эта связь закреплена в StagedFileJobService.
bench и summary используют staged-механику. Название summary не доказывает LLM-суммаризацию содержания: здесь это интерфейс решений, случаев и результатов сравнения.
Источники: staged jobs, page modes, bench data.
Данные имеют разное время жизни
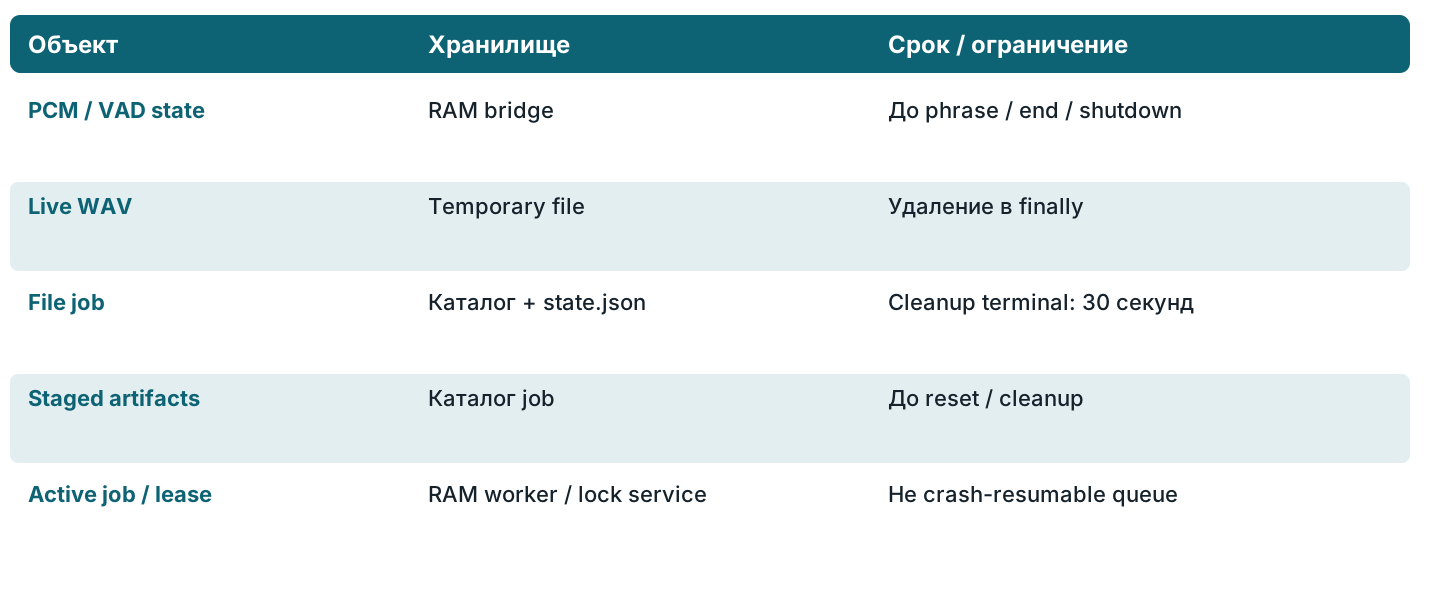
| Данные | Владелец / место | Жизненный цикл |
|---|---|---|
| PCM и VAD buffer | bridge RAM | до выделения фразы, end или shutdown |
| WAV живой фразы | temp file | удаляется после попытки LinTO call |
| input, normalized.wav, chunks | FileJobStore | каталог job в настроенном storage |
| state.json и transcript | FileJobStore | HTTP snapshot, перезапись по событиям |
| transcription.json / diarization.json / combined.json | staged job | переиспользование, инвалидация, reset |
| активная задача / cancellation | worker RAM + cancel.requested | один активный job на worker |
| глобальная lease | FileJobLockService RAM | TTL, heartbeat, release; рестарт теряет lock |
| результаты benchmark | BenchResultStore | timing, RTF и quality_proxy |
FileJobStore.write_state пишет JSON прямо в конечный файл. Отдельная атомарная публикация snapshot и координация нескольких writers по исходнику не подтверждены. Обычный file worker планирует cleanup терминальных jobs с задержкой 30 секунд; staged-artifacts сохраняются для следующих шагов и удаляются через явный reset/cleanup. Файловый snapshot не следует представлять долговечной историей пользователя.
end закрывает stream state, shutdown очищает все streams. Отдельный idle TTL для потерянного stream в исследованной реализации не найден. Проверка потери end и длительной тишины нужна перед заявлением об ограниченной памяти.
Model transport — отдельная граница
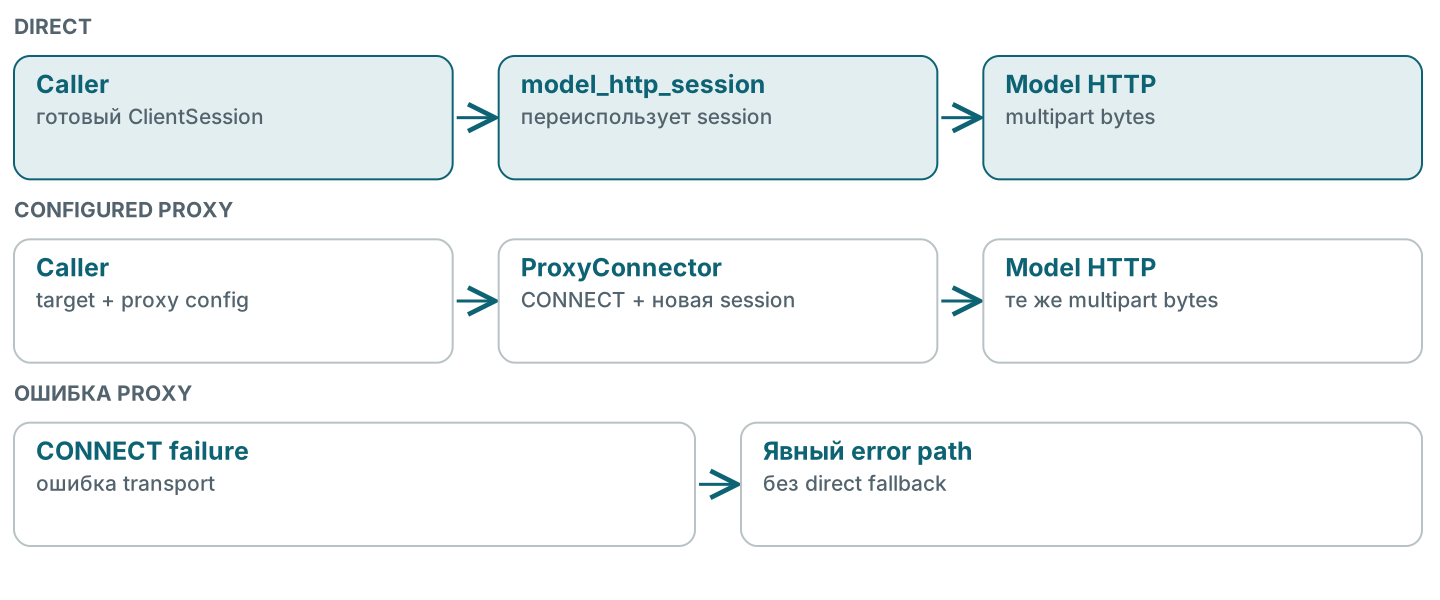
При прямом доступе model_http_session переиспользует переданный ClientSession. При configured proxy создаёт aiohttp_socks.ProxyConnector и отдельную сессию для CONNECT. Multipart-байты идут через туннель к модельному HTTP endpoint. JSON-обёртка proxy для этой передачи не используется.
Изоляция CONNECT защищает бинарный контракт; её нельзя убрать как «лишний слой», не воспроизведя byte-safe upload. При этом новая proxy session на каждый вызов оставляет кандидата на оптимизацию connection reuse — с отдельным pool на transport target, без смешивания endpoint и credentials. Выигрыш потребует измерения handshake и transfer time.
Тесты model transport проверяют direct reuse и выбор connector. Они не подтверждают живой туннель на H100.
Как найти вызов, который отправляет аудио
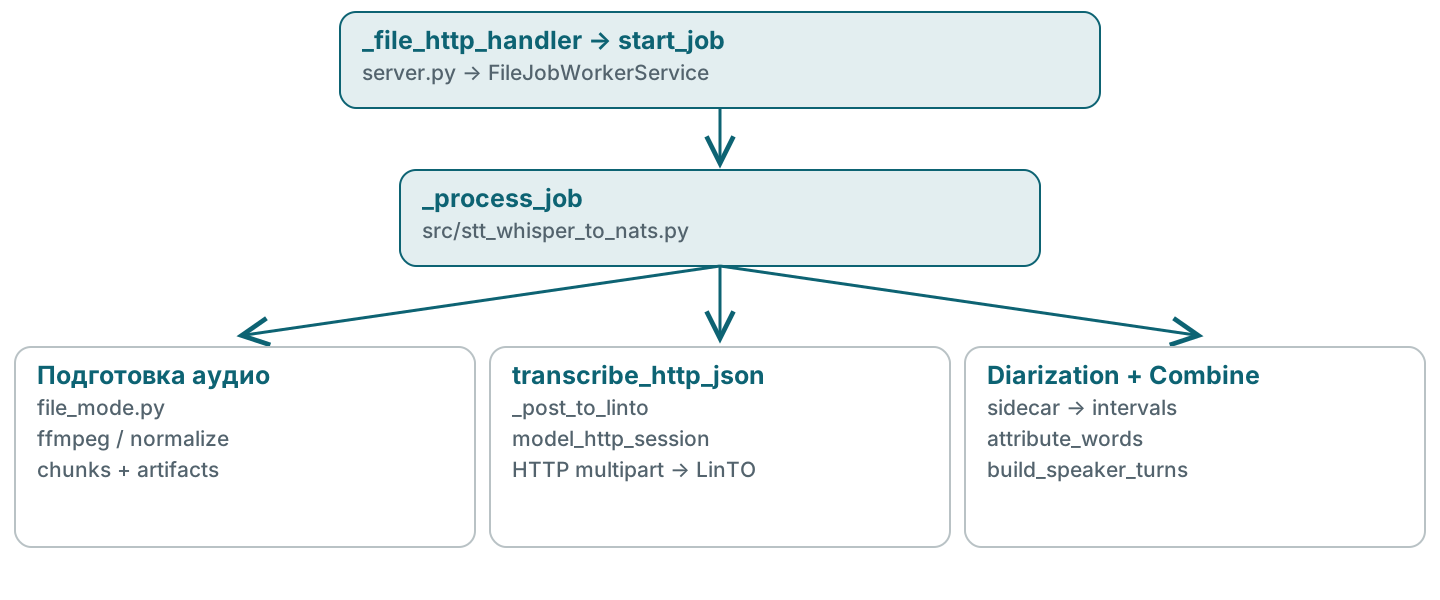
_file_http_handler сохраняет upload и вызывает FileJobWorkerService.start_job. Фоновая _process_job готовит аудио и вызывает transcribe_http_json, затем _post_to_linto. Последняя выбирает model_http_session, формирует multipart и читает ответ модели.
В staged-режиме входом служит _staged_step_http_handler → start_step. Ветка _run_combine заканчивается локальными attribute_words, build_speaker_turns и записью результата. Это другой call tree без inference-boundary.
HTTP и сообщения образуют общий контракт WebUI
| Интерфейс | Смысл | Значимые поля / ограничения |
|---|---|---|
POST <base>/api/file-transcribe |
обычная загрузка и запуск | multipart; job_id должен предшествовать file |
GET <base>/api/file-job |
восстановить snapshot | job_id, session, page mode |
POST <base>/api/file-prepare |
подготовить staged job | источник + выбранная конфигурация |
POST <base>/api/file-{step}-step |
transcribe / diarize / combine | готовность предыдущих artifacts |
POST <base>/api/reset-session |
отменить/очистить | scope текущей страницы и сессии |
GET <base>/api/diagnostics |
проверить зависимости | может запускать активные smoke calls |
/acquire, /heartbeat, /release |
общий lock service | owner, lease TTL, при занятости 423 |
POST /diarize |
sidecar diarization | audio, параметры модели, интервалы говорящих |
inference.whisper.file.event.<job> |
события задания | progress / done / error; snapshot через HTTP |
...file.session.<session> и diar prefixes |
scoped события | источник и браузер должны согласовать prefix |
Core NATS не сохраняет пропущенные сообщения. HTTP snapshot помогает браузеру восстановить текущее состояние задания, пока каталог существует. Durable replay событий и возобновление computation после падения из этого не следуют.
Sidecars выполняют одинаковую роль разными моделями
Pyannote загружает pipeline, проверяет доступ к модели и сериализует inference своим lock. Sherpa-ONNX и Sortformer имеют отдельные зависимости и HTTP реализации. У Sortformer есть chunking длинных записей и сопоставление speaker labels между перекрывающимися окнами.
Общий adapter превращает их payload в DiarizationResult, затем attribute_words сопоставляет word timestamps с интервалами. Если ASR не вернул word timestamps, точное соединение с говорящими не гарантируется; такая ошибка выделена отдельно.
Параметры speaker count, batch и audio format влияют и на скорость, и на результат. Их следует сохранять вместе с benchmark, а не сравнивать «модели вообще».
Deployment и проверки
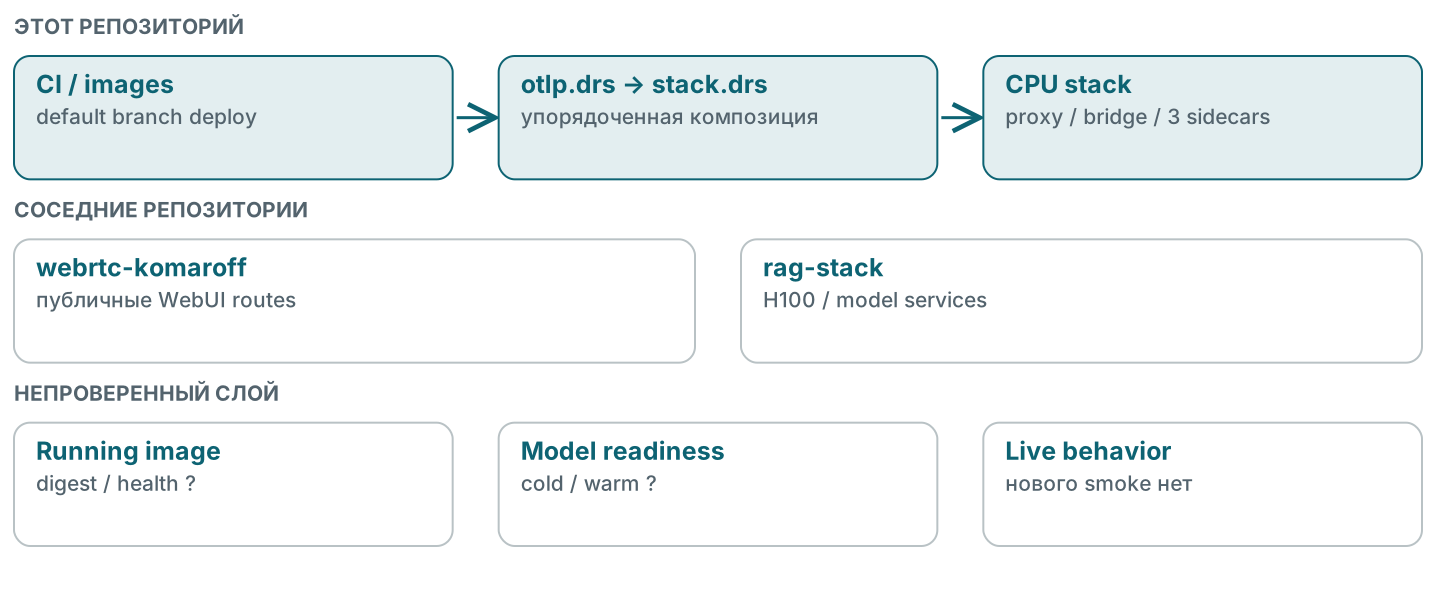
Собственный deployment wrapper применяет упорядоченную композицию otlp.drs → stack.drs с --prune. Для pyannote в CPU stack явно задан DEVICE=cpu. Публичные пути /whisper-trasncription, /whisper-diarization, /whisper-staged, /whisper-bench, /whisper-summary, /status принадлежат WebRTC DRS. Опечатка в первом пути — существующий контракт URL.
Локальный python -m unittest discover -s tests прошёл 115 тестов 16.09.2026. В выводе есть предупреждения aiohttp NotAppKeyWarning и намеренно моделируемая ошибка загрузки pyannote; итог suite — OK. Эти проверки охватывают transport, health, diarization helpers, staged artifacts, WebUI modes, locks, snapshots и diagnostics. Они не выполняют реальное GPU-распознавание.
Отдельная CI job tests закомментирована. Deployment job ограничена default branch. Наличие этих деклараций и локальный зелёный suite не доказывают проверенный deployed image.
Что измерять перед расширением нагрузки
RTF — отношение времени обработки к длительности записи — уже рассчитывается в benchmark. quality_proxy отражает косвенные характеристики результата; это не WER (ошибка распознавания слов) и не DER (ошибка разделения говорящих). Для честного сравнения моделей нужен размеченный corpus, одинаковые входы и раздельные cold/warm-прогоны.
Следующие измерения закрыли бы основные неизвестные: pending tasks и bytes на поток, p95 очереди ASR, время normalize/upload/inference/combine, сохранность job после crash, доля потерянных событий при reconnect и число активных leases. Пока таких baseline в этом исследовании нет.
Где расширять систему
Новый backend начинается с совместимого HTTP sidecar и его health, затем подключается через settings, transport и bench config. Новое представление результата лучше строить из сохранённых words/segments, как уже делает Combine. Масштабирование файловой обработки потребует job queue, независимых workers и определённого владельца storage. Масштабирование живого PCM требует сохранения порядка и принадлежности stream одному worker.
Следует сохранить единый бинарный transport contract и разделение ASR/diarization результатов. Самые заметные риски — process-local execution, общий lock в RAM, короткая жизнь ordinary jobs и отсутствие ограниченной admission-очереди. Их решение не требует автоматически заменять все модели или WebUI.